Невидим ли е сайтът ви за ChatGPT? Как да проверите достъпа на AI ботове

Накратко: сайтът ви е скрит от търсенето в ChatGPT, ако robots.txt забранява достъпа на OAI-SearchBot или защитната стена му връща грешка 403. Същото важи за Claude-SearchBot при Claude, PerplexityBot при Perplexity и Googlebot при AI Overviews на Google. Ако блокирате ботове за обучение като GPTBot или ClaudeBot, страниците ви остават в отговорите на AI търсачките.
Потенциален клиент пита ChatGPT за „най-добрата фирма за ИТ поддръжка наблизо“. В отговора има три фирми с линкове към сайтовете им. Вашата не е сред тях, въпреки че страниците с услугите ви са на първа страница в Google.
Първото, което трябва да изключите, е блокиране. Достъпът на AI ботове зависи от настройки, в които повечето собственици на бизнес никога не поглеждат. Един ред в robots.txt, една опция в мрежата за доставка на съдържание (Content Delivery Network или CDN) или едно правило в защитната стена (firewall) може напълно да попречи на ChatGPT, Claude, Perplexity или AI функциите на Google да четат сайта ви.
Проверката отнема четири стъпки и около 15 минути. По-долу ще намерите ботовете, които имат значение, точните пътища до файловете, които да проверите в SPanel, и начин да решите кои ботове да допуснете.
Ако предпочитате някой друг да следи защитната стена вместо вас, управляваният облачен хостинг на NS1 включва SPanel и SShield във всеки план, а сигурността и ъпдейтите на сървъра поема екипът по поддръжка.
Какво е AI обхождащ бот?
AI обхождащият бот (AI crawler) е автоматизирана програма, която изтегля уеб страници за AI компания. Целта може да е обучение на модели, изграждане на индекс за AI отговорите или прочитане на страница в реално време, когато потребител зададе въпрос. Всеки такъв бот се представя с user-agent токен, например GPTBot или ClaudeBot. Именно по този токен се ориентират правилата в robots.txt и в защитната стена.
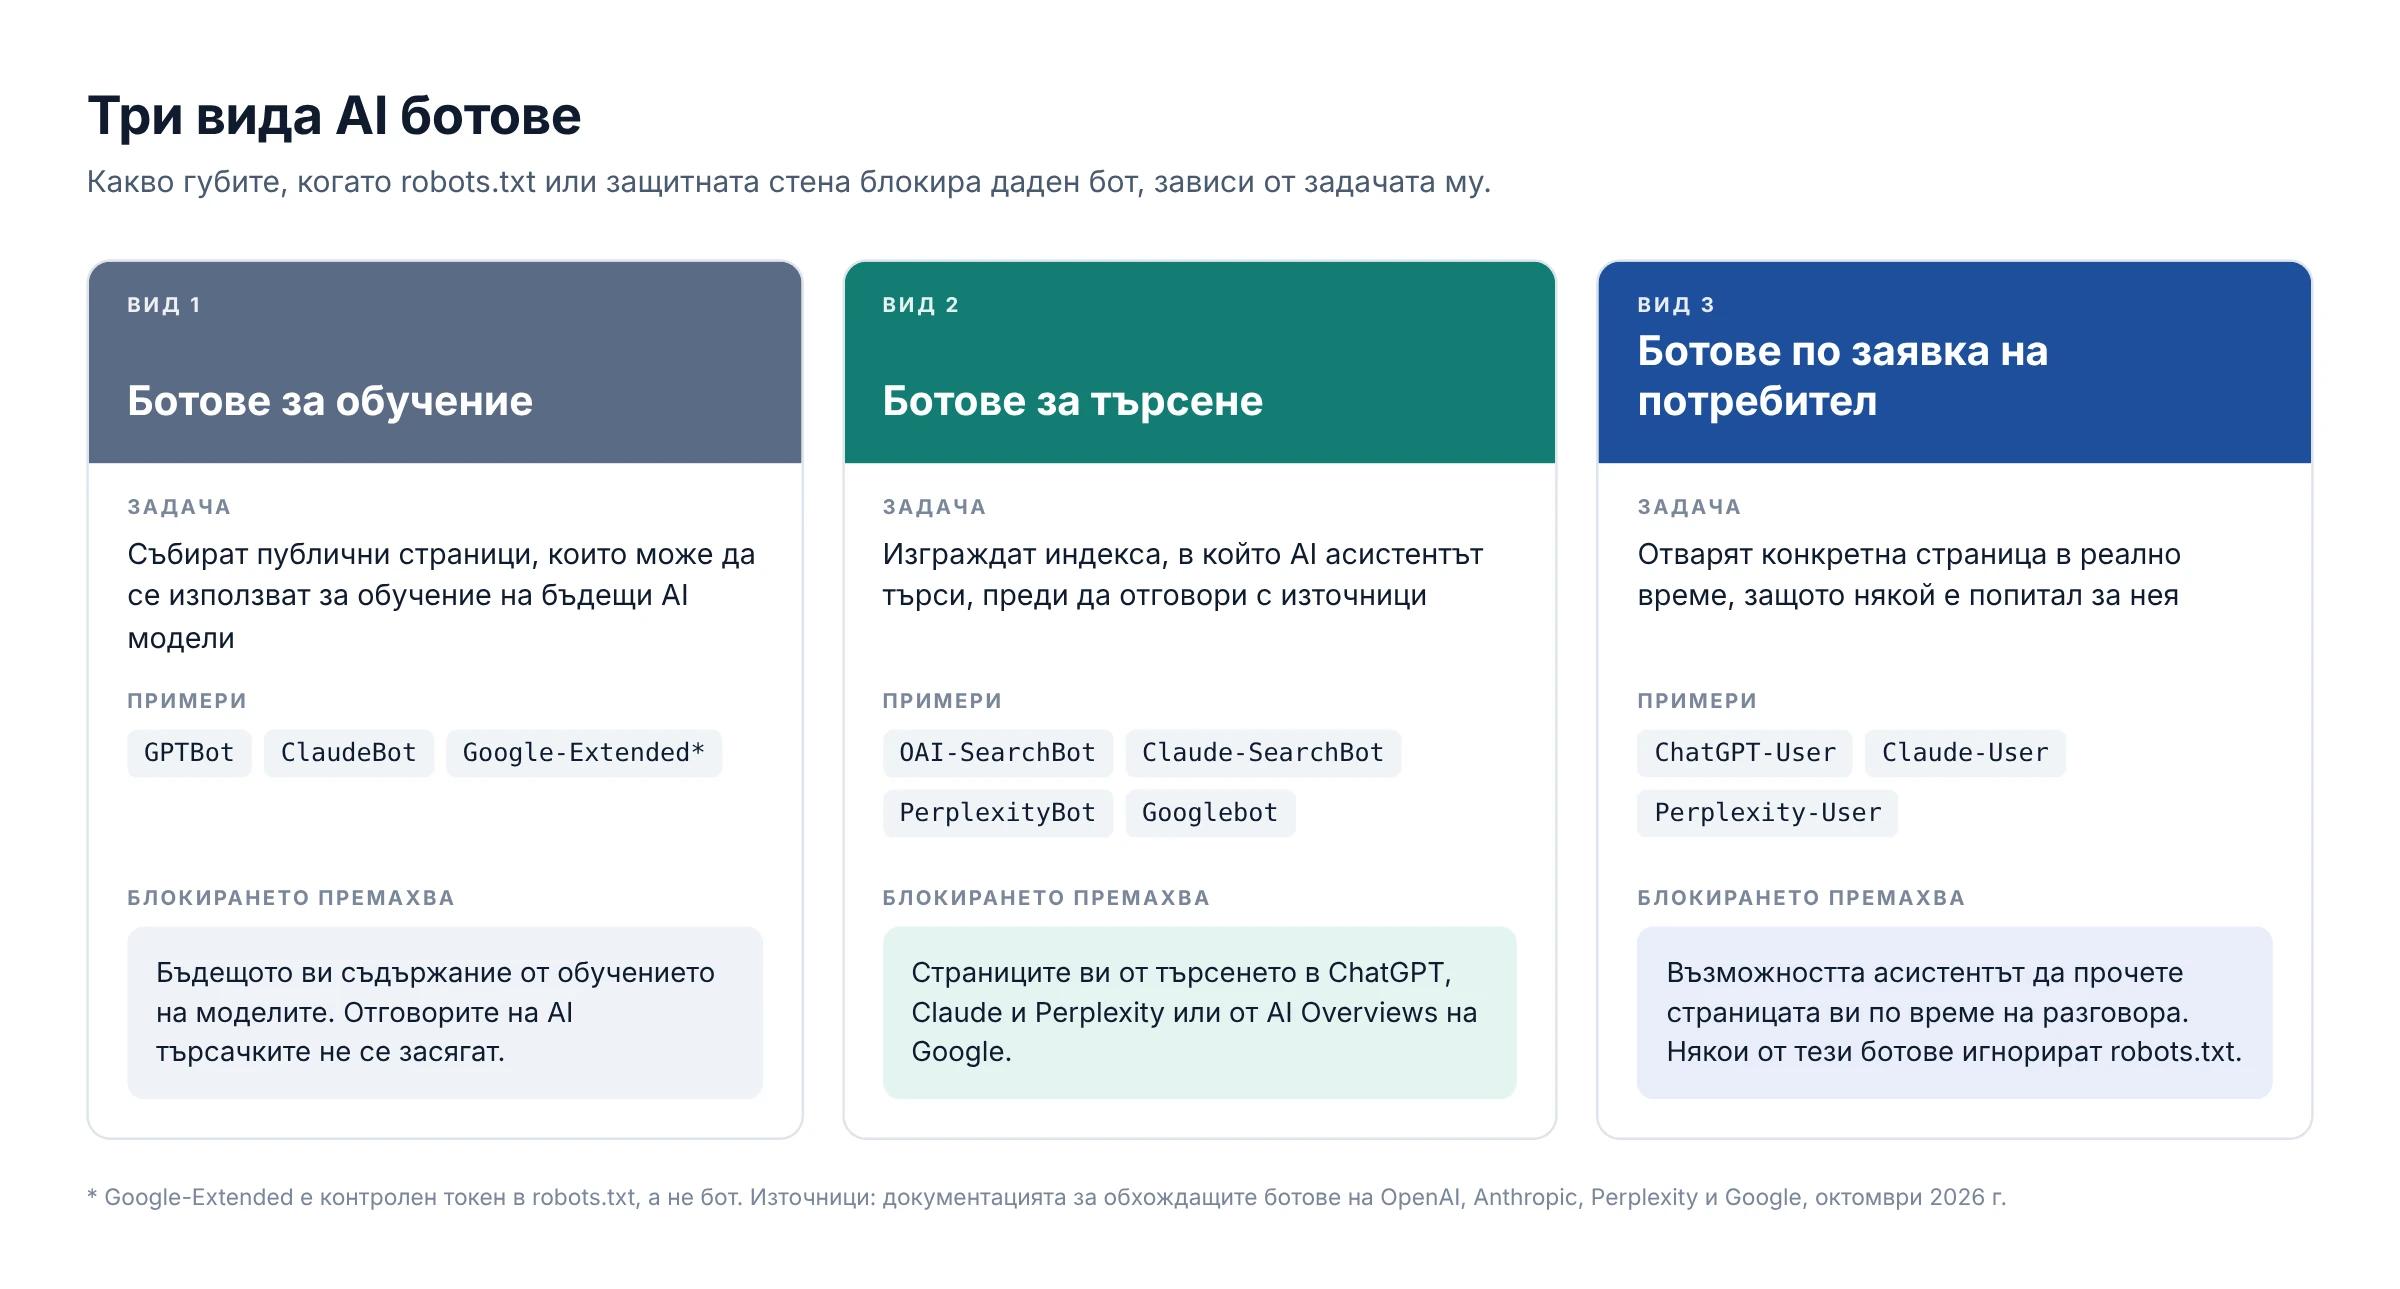
Има три вида AI обхождащи ботове и всеки върши различна работа:
- Ботовете за обучение събират публични страници, които може да се използват за обучение на бъдещи AI модели. GPTBot (OpenAI) и ClaudeBot (Anthropic) са ботове за обучение.
- Ботовете за търсене изграждат индекса, в който AI асистентът търси, преди да напише отговор с цитирани източници. OAI-SearchBot, Claude-SearchBot и PerplexityBot са ботове за търсене.
- Ботовете по заявка на потребител отварят конкретна страница в реално време, защото някой е попитал за нея. Такива са ChatGPT-User, Claude-User и Perplexity-User.
Какво губите, когато блокирате даден бот, зависи от вида му, а не от компанията зад него.
Google работи по различен начин. AI Overviews и AI Mode на Google не използват отделен AI обхождащ бот. Според ръководството на Google за AI функциите (на английски) е достатъчно страницата да е индексирана от Googlebot и да може да се показва с фрагмент (snippet) в Search. Google-Extended е контролен токен в robots.txt, а не бот. Той управлява обучението на моделите Gemini и използването на съдържанието за grounding, т.е. за подкрепа на отговорите им с реални източници.
Видът на AI бота показва какво ви струва блокирането му, затова първо определете с какво се занимава ботът и чак тогава пишете правило.
Кои AI ботове са важни за един бизнес сайт?
Дали ChatGPT, Claude, Perplexity и AI Overviews на Google могат да четат бизнес сайта ви, зависи от 10 user-agent токена на четири компании.
Таблицата по-долу сравнява задачата на всеки бот и какво премахва блокирането му. Данните са от документацията на самите компании към октомври 2026 г.
| Бот (user-agent токен) | Компания | Задача | Какво премахва блокирането | Документация (на английски) |
|---|---|---|---|---|
| GPTBot | OpenAI | Обучение | Бъдещото ви съдържание от обучението на моделите на OpenAI. Не засяга търсенето в ChatGPT. | Ботове на OpenAI |
| OAI-SearchBot | OpenAI | Индекс за търсене | Страниците ви от отговорите на търсенето в ChatGPT (навигационни линкове пак може да се показват). | Ботове на OpenAI |
| ChatGPT-User | OpenAI | По заявка на потребител | Възможността ChatGPT да отвори страницата ви, когато потребител попита. Според OpenAI robots.txt може да не важи за този бот. | Ботове на OpenAI |
| ClaudeBot | Anthropic | Обучение | Бъдещото ви съдържание от обучението на моделите на Anthropic. | Ботове на Anthropic |
| Claude-SearchBot | Anthropic | Индекс за търсене | Индексирането за резултатите от търсене в Claude, което може да намали видимостта ви там. | Ботове на Anthropic |
| Claude-User | Anthropic | По заявка на потребител | Възможността Claude да зареди страницата ви в отговор на въпрос от потребител. | Ботове на Anthropic |
| PerplexityBot | Perplexity | Индекс за търсене (не за обучение) | Страниците ви от резултатите в Perplexity. | Ботове на Perplexity |
| Perplexity-User | Perplexity | По заявка на потребител | Малко, ако разчитате само на robots.txt: според Perplexity този бот по принцип игнорира robots.txt. | Ботове на Perplexity |
| Googlebot | Индекс за търсене (захранва и AI Overviews, и AI Mode) | Google Search, AI Overviews и AI Mode, всичко наведнъж. | Основни обхождащи ботове на Google | |
| Google-Extended | Контролен токен за обучение и grounding на Gemini | Използването на съдържанието ви за обучение и grounding на Gemini. Не засяга индексирането и класирането в Google Search. | Основни обхождащи ботове на Google |
Най-важното от таблицата: ако блокирате бот за обучение като GPTBot или ClaudeBot, страниците ви остават в отговорите на AI търсачките. Блокирането на OAI-SearchBot, Claude-SearchBot, PerplexityBot или Googlebot обаче ги премахва или намалява присъствието им там.
Два детайла от документацията променят начина, по който проверявате.
Първият е времето: според OpenAI търсенето в ChatGPT отразява промяна в robots.txt след около 24 часа, а Perplexity посочва до 24 часа.
Вторият е самоличността: всеки може да фалшифицира user agent, затова OpenAI, Anthropic, Perplexity и Google публикуват IP диапазоните, от които работят ботовете им (например openai.com/searchbot.json и claude.com/crawling/bots.json). Заявка, която се представя за GPTBot, но идва от IP адрес извън списъка на OpenAI, не е от GPTBot.
Ако допуснете ботовете за търсене и тези по заявка на потребител, сайтът ви може да бъде цитиран. Ботовете за обучение са отделно бизнес решение.
Как да проверите достъпа на AI ботове до сайта си?
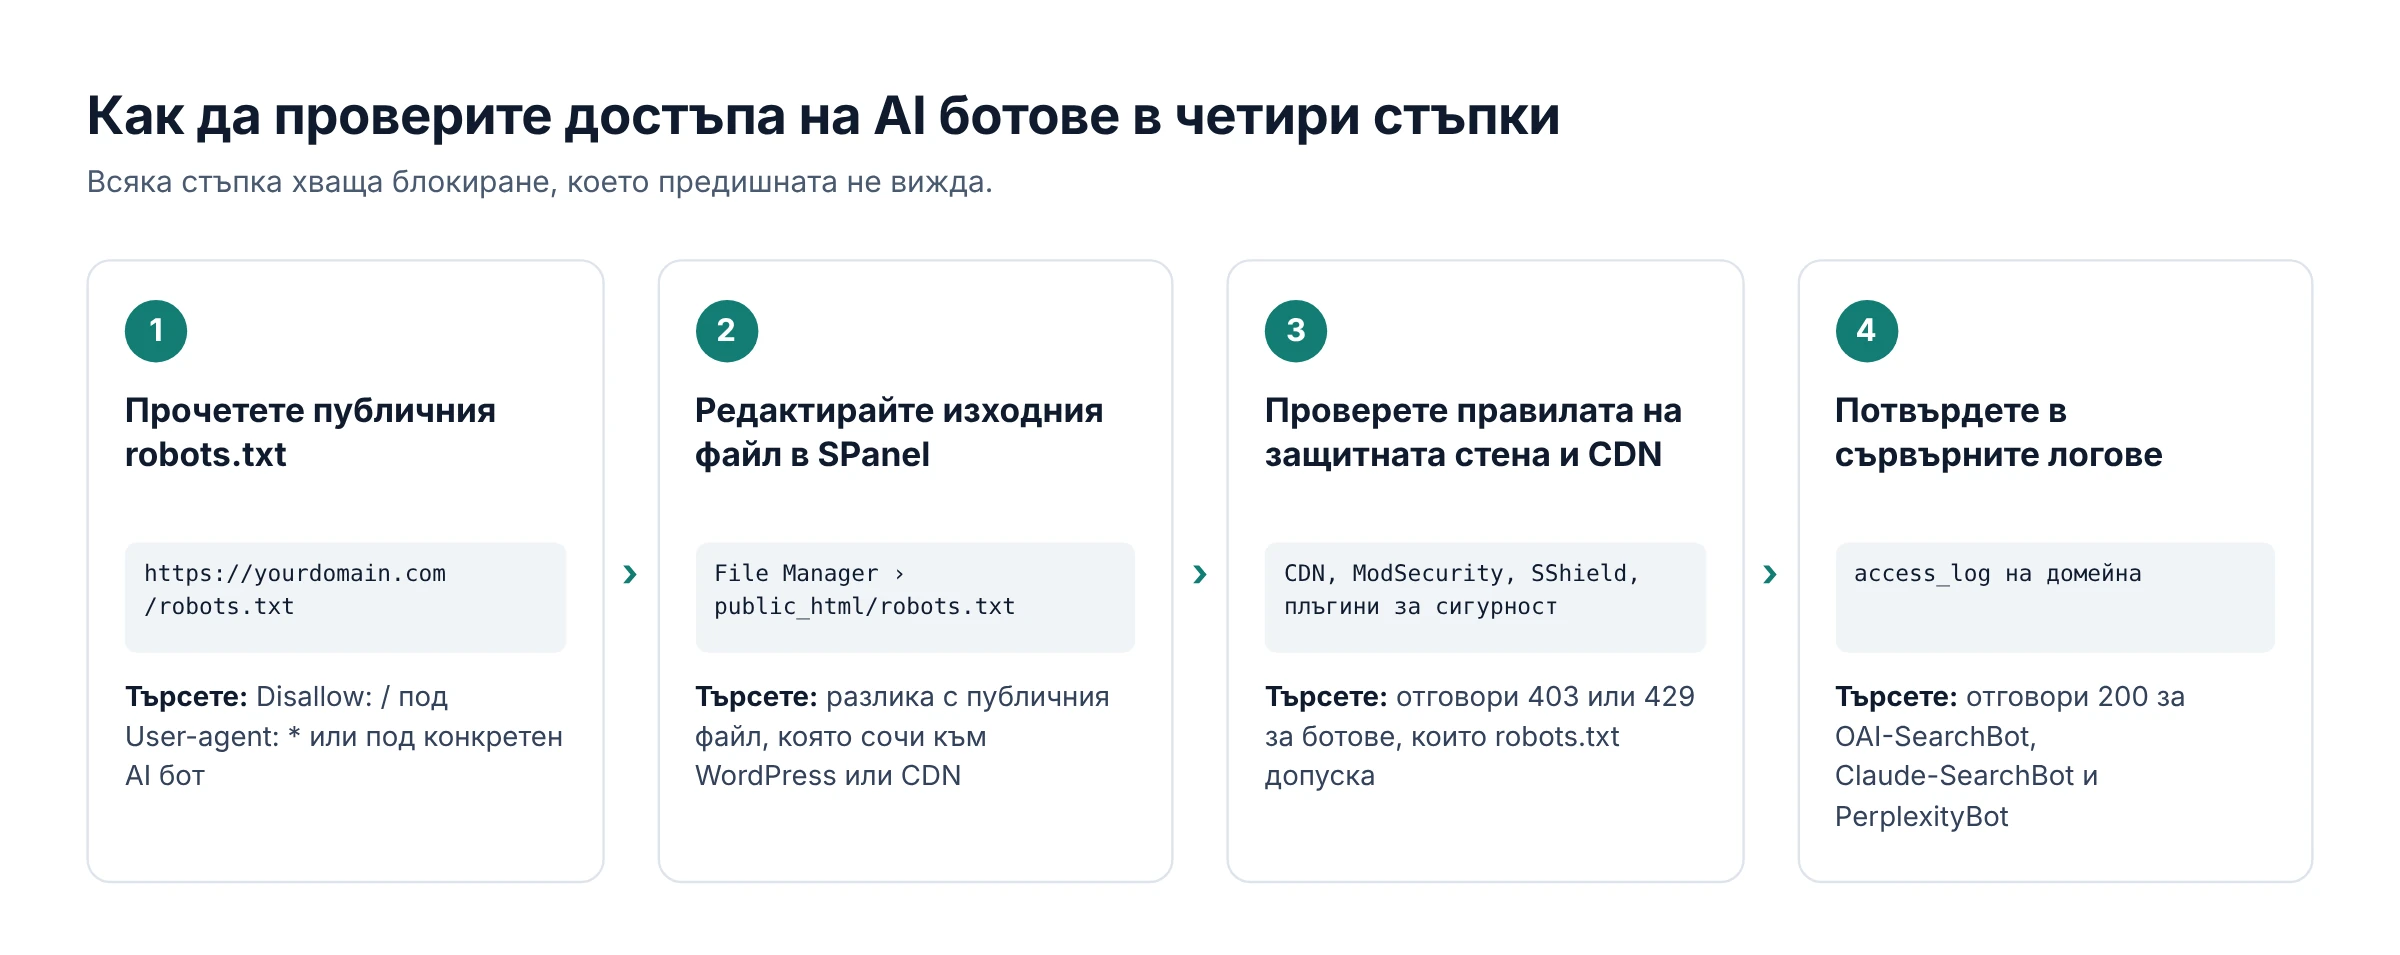
Проверката минава през четири стъпки: прочитате публичния robots.txt, редактирате изходния файл във File Manager на SPanel, преглеждате правилата на защитната стена и CDN и потвърждавате реалните посещения на ботовете в сървърните логове. Следвайте ги поред, защото всяка стъпка хваща блокирания, които предишната не вижда.
Стъпка 1. Прочетете публичния robots.txt
Стъпка 1 проверява публичния файл на адрес https://yourdomain.com/robots.txt. Това е точното копие, което всеки обхождащ бот, спазващ правилата, изтегля, преди да поиска страница. Отворете адреса в браузър и потърсете три неща:
- Група User-agent: * с Disallow: /, която блокира всеки бот, спазващ правилата, ако той няма собствена група
- Група с конкретно име, например User-agent: OAI-SearchBot или User-agent: Googlebot, с Disallow: /
- Ред Disallow: /, останал от тестова среда или редизайн, който скрива целия сайт от всички ботове в съответната група
Едно Disallow: / под грешния user agent е достатъчно, за да скрие всички страници от този бот.
Ботовете следват най-конкретната група, която ги назовава. Ако във файла ви има група User-agent: GPTBot, GPTBot изцяло игнорира групата User-agent: *. Затова прочетете всички групи, а не само първата. Поддомейните, като shop.yourdomain.com, имат собствен robots.txt, така че проверете всеки от тях.
Ботовете се подчиняват на публичния адрес, затова го прочетете, преди да отваряте файлове на сървъра.
Стъпка 2. Намерете и редактирайте robots.txt във File Manager на SPanel
Стъпка 2 проверява изходния файл public_html/robots.txt в основната директория (document root) на главния ви домейн. За целта използвате File Manager в SPanel, контролния панел, който използваме в NS1. Следвайте тези пет стъпки:
- Отворете File Manager. Логнете се в User Interface на SPanel (обикновено https://yourdomain.com/spanel) и отворете File Manager от раздела Files.
- Отидете в основната директория. Отворете public_html/.
- Направете бекъп на файла. Изберете robots.txt и кликнете Download, за да запазите копие.
- Редактирайте и запазете. Отворете robots.txt във вградения редактор, променете или изтрийте блокиращите редове и запазете. File Manager не променя оригиналните права за достъп (permissions) на файла при запис.
- Проверете отново публичния файл. Презаредете https://yourdomain.com/robots.txt и се уверете, че промяната се вижда.
Ако предпочитате да редактирате на компютъра си, променете изтегленото копие и го качете обратно чрез File Manager в SPanel
В public_html/ няма robots.txt, но на публичния адрес все пак има правила?
Значи файлът идва от друго място. WordPress показва виртуален robots.txt, когато няма физически файл, а SEO плъгини като Yoast SEO и Rank Math ви позволяват да редактирате тези правила от WordPress. Физически robots.txt в public_html/ замества виртуалния файл на WordPress. Правила може да добавя и CDN. Когато някоя категория AI ботове е настроена на блокиране, управляваният robots.txt на Cloudflare (на английски) поставя Disallow правила за AI ботове пред вашите собствени или създава robots.txt, ако такъв няма.
Ако публичният robots.txt и файлът в public_html/ се различават, правилото, което трябва да промените, е в WordPress или в CDN, а не на диска.
Стъпка 3. Проверете правилата на защитната стена, CDN и WAF
Стъпка 3 проверява трите слоя, които могат да върнат грешка 403 (Forbidden) на бот дори когато robots.txt му разрешава достъп:
- Настройките за ботове в CDN. От 1 юли 2026 г. Cloudflare разделя AI ботовете в категориите Search, Agent и Training, а от 15 септември 2026 г. новите домейни в Cloudflare блокират по подразбиране ботовете от Training и Agent на страници с реклами. В обявлението на Cloudflare (на английски) се уточнява, че блокирането на Training спира и многоцелеви обхождащи ботове като Googlebot, Applebot и BingBot.
- Защитната стена за уеб приложения на сървъра (Web Application Firewall или WAF). В SPanel ModSecurity WAF е включен по подразбиране за всеки домейн и проверява всяка заявка за признаци на атака. Над него SShield добавя блокиране на заплахи в реално време, за което ще стане дума в следващия раздел.
- Плъгините за сигурност. WordPress плъгини с функции като „block bad bots“ или ограничаване на броя заявки (rate limiting) може да връщат грешки 403 или 429 (Too Many Requests) на ботове, които зареждат много страници за кратко време.
Ако ModSecurity е слоят, който отказва достъп на даден бот, не го изключвайте, а помолете някой от техническата поддръжка да коригира правилото. Опцията за ModSecurity в SPanel изключва цялата система за съответния домейн, а не едно правило. Така заедно с фалшивата тревога губите и защитата срещу SQL инжекции и cross-site scripting.
Блокирането в защитната стена има предимство пред разрешаващ robots.txt, така че изрядният robots.txt не доказва, че ботовете минават.
За да тествате правилата за user agent от собствения си компютър, заредете началната си страница, като се представите за GPTBot:
curl -s -o /dev/null -w „%{http_code}\n“ -A „Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot“ https://yourdomain.com/
Отговор 200 означава, че този user agent минава, а 403 означава, че някое правило го блокира. Тестът не може да провери правилата по IP адрес. Защитна стена, която сверява ботовете с публикуваните IP диапазони, може да блокира вашата тестова заявка и въпреки това да пусне истинския GPTBot. Anthropic отбелязва, че ако блокирате IP адресите ѝ, ботовете ѝ може да не успеят да прочетат и robots.txt, а Perplexity препоръчва да разрешите публикуваните ѝ IP диапазони в WAF.
Стъпка 4. Потвърдете посещенията на ботовете в сървърните логове
Стъпка 4 проверява дневника за достъп (access log) на домейна ви.
Това е единственият запис на това какво точно е получил всеки бот от сървъра ви. File Manager в SPanel ви позволява да изтегляте файлове от директорията с логовете на уеб сървъра. Така можете да отворите дневника във всеки текстов редактор и да потърсите user-agent токените от таблицата по-горе. Ако имате SSH достъп, една команда преброява кодовете на отговор, които е получил всеки AI бот:
grep -E
„GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User“ access_log | awk ‘{print $9}’ | sort | uniq -c
Таблицата по-долу обяснява какво означава всеки резултат за достъпа на AI ботовете.
| Резултат в лога | Какво означава | Какво да направите |
|---|---|---|
| 200 | Ботът е получил страницата. | Нищо, достъпът работи. |
| 403 | Защитна стена, WAF или плъгин е отказал заявката. | Проверете отново стъпка 3. |
| 429 | Ограничението на броя заявки е спряло бота. | Вдигнете лимита или разрешете публикуваните IP диапазони на съответната компания. |
| 404 | Ботът е поискал адрес, който не съществува. | Поправете счупените вътрешни линкове и пренасочвания. |
| Няма редове за 30 дни | Ботът не е идвал или CDN го блокира, преди да стигне до сървъра ви. | Проверете статистиката за ботове в CDN. |
Редовете 403 и „Няма редове“ са двата резултата, които сочат блокиране, а не проблем със съдържанието.
Сървърните логове показват какво са получили ботовете, а не какво са целели правилата ви. Затова стъпка 4 има последната дума за достъпа на AI ботовете.
Допълнете проверките за AI ботове с Website Monitoring в SPanel
SPanel предоставя и опция Website Monitoring, която проверява дали дадена публична страница остава достъпна и връща очакваното съдържание. Мониторингът работи от сървъра, на който е инсталирана услугата. В таблото му виждате ъптайма на сайта, средното време за отговор, Time to first byte (TTFB), случаите на бавно зареждане и състоянието на SSL сертификата. Така засичате обикновените сривове и скритите грешки в приложението, докато проучвате ограниченията, насочени конкретно към AI ботовете.
Как да настроите мониторинга в SPanel:
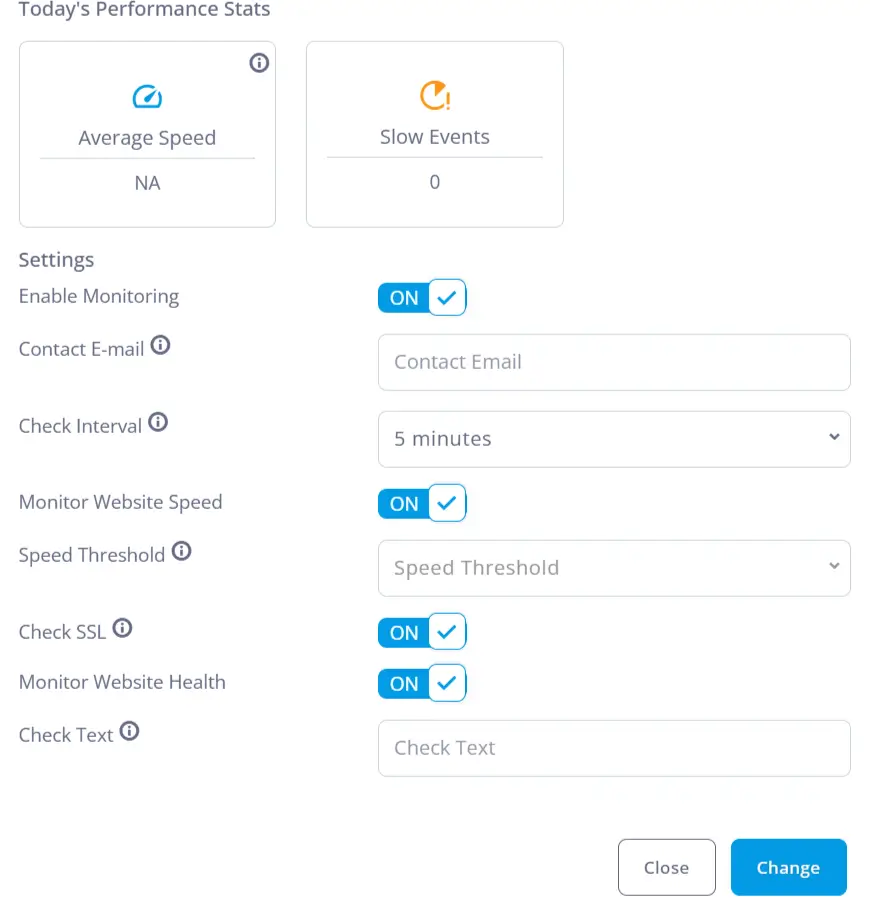
- Отворете Domains > Website Monitoring в SPanel, намерете домейна и изберете Actions, за да отворите настройките за мониторинг.
- Активирайте Enable Monitoring и задайте имейл за контакт, интервал на проверка (1, 5, 10 или 15 минути), праг за скоростта на сайта и проверките за SSL и за състоянието на сайта.
- В полето Check Text въведете кратка фраза, която не се променя и трябва да присъства в отговора на страницата, например името на сайта или постоянно заглавие. Ако страницата връща HTTP 200, но фразата липсва, мониторингът може да я отбележи като проблемна. Избягвайте текст, който се променя според посетителя, езика, сесията или рендирането с JavaScript.
- Натиснете Force Manual Check, за да пуснете проверка веднага, и прегледайте показаните статистики и известия.
Защо AI ботовете пропускат съдържание, което посетителите виждат?
AI ботовете пропускат съдържание, което се зарежда само чрез JavaScript, защото основните AI ботове четат суровия HTML, който изпраща сървърът ви, и не изпълняват скриптове. Проучване на Vercel и MERJ от декември 2024 г. (на английски) установява, че нито един от измерените основни AI ботове не рендира JavaScript. Сред тях са GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot и PerplexityBot. JavaScript файловете са 11,50% от заявките на обхождащия бот на ChatGPT и 23,84% от тези на обхождащия бот на Claude, но ботовете не са ги изпълнявали.
Googlebot, за разлика от тях, рендира JavaScript, както пише в основите на JavaScript SEO от Google (на английски). Затова една страница може да се класира в Google, а за ChatGPT да изглежда празна.
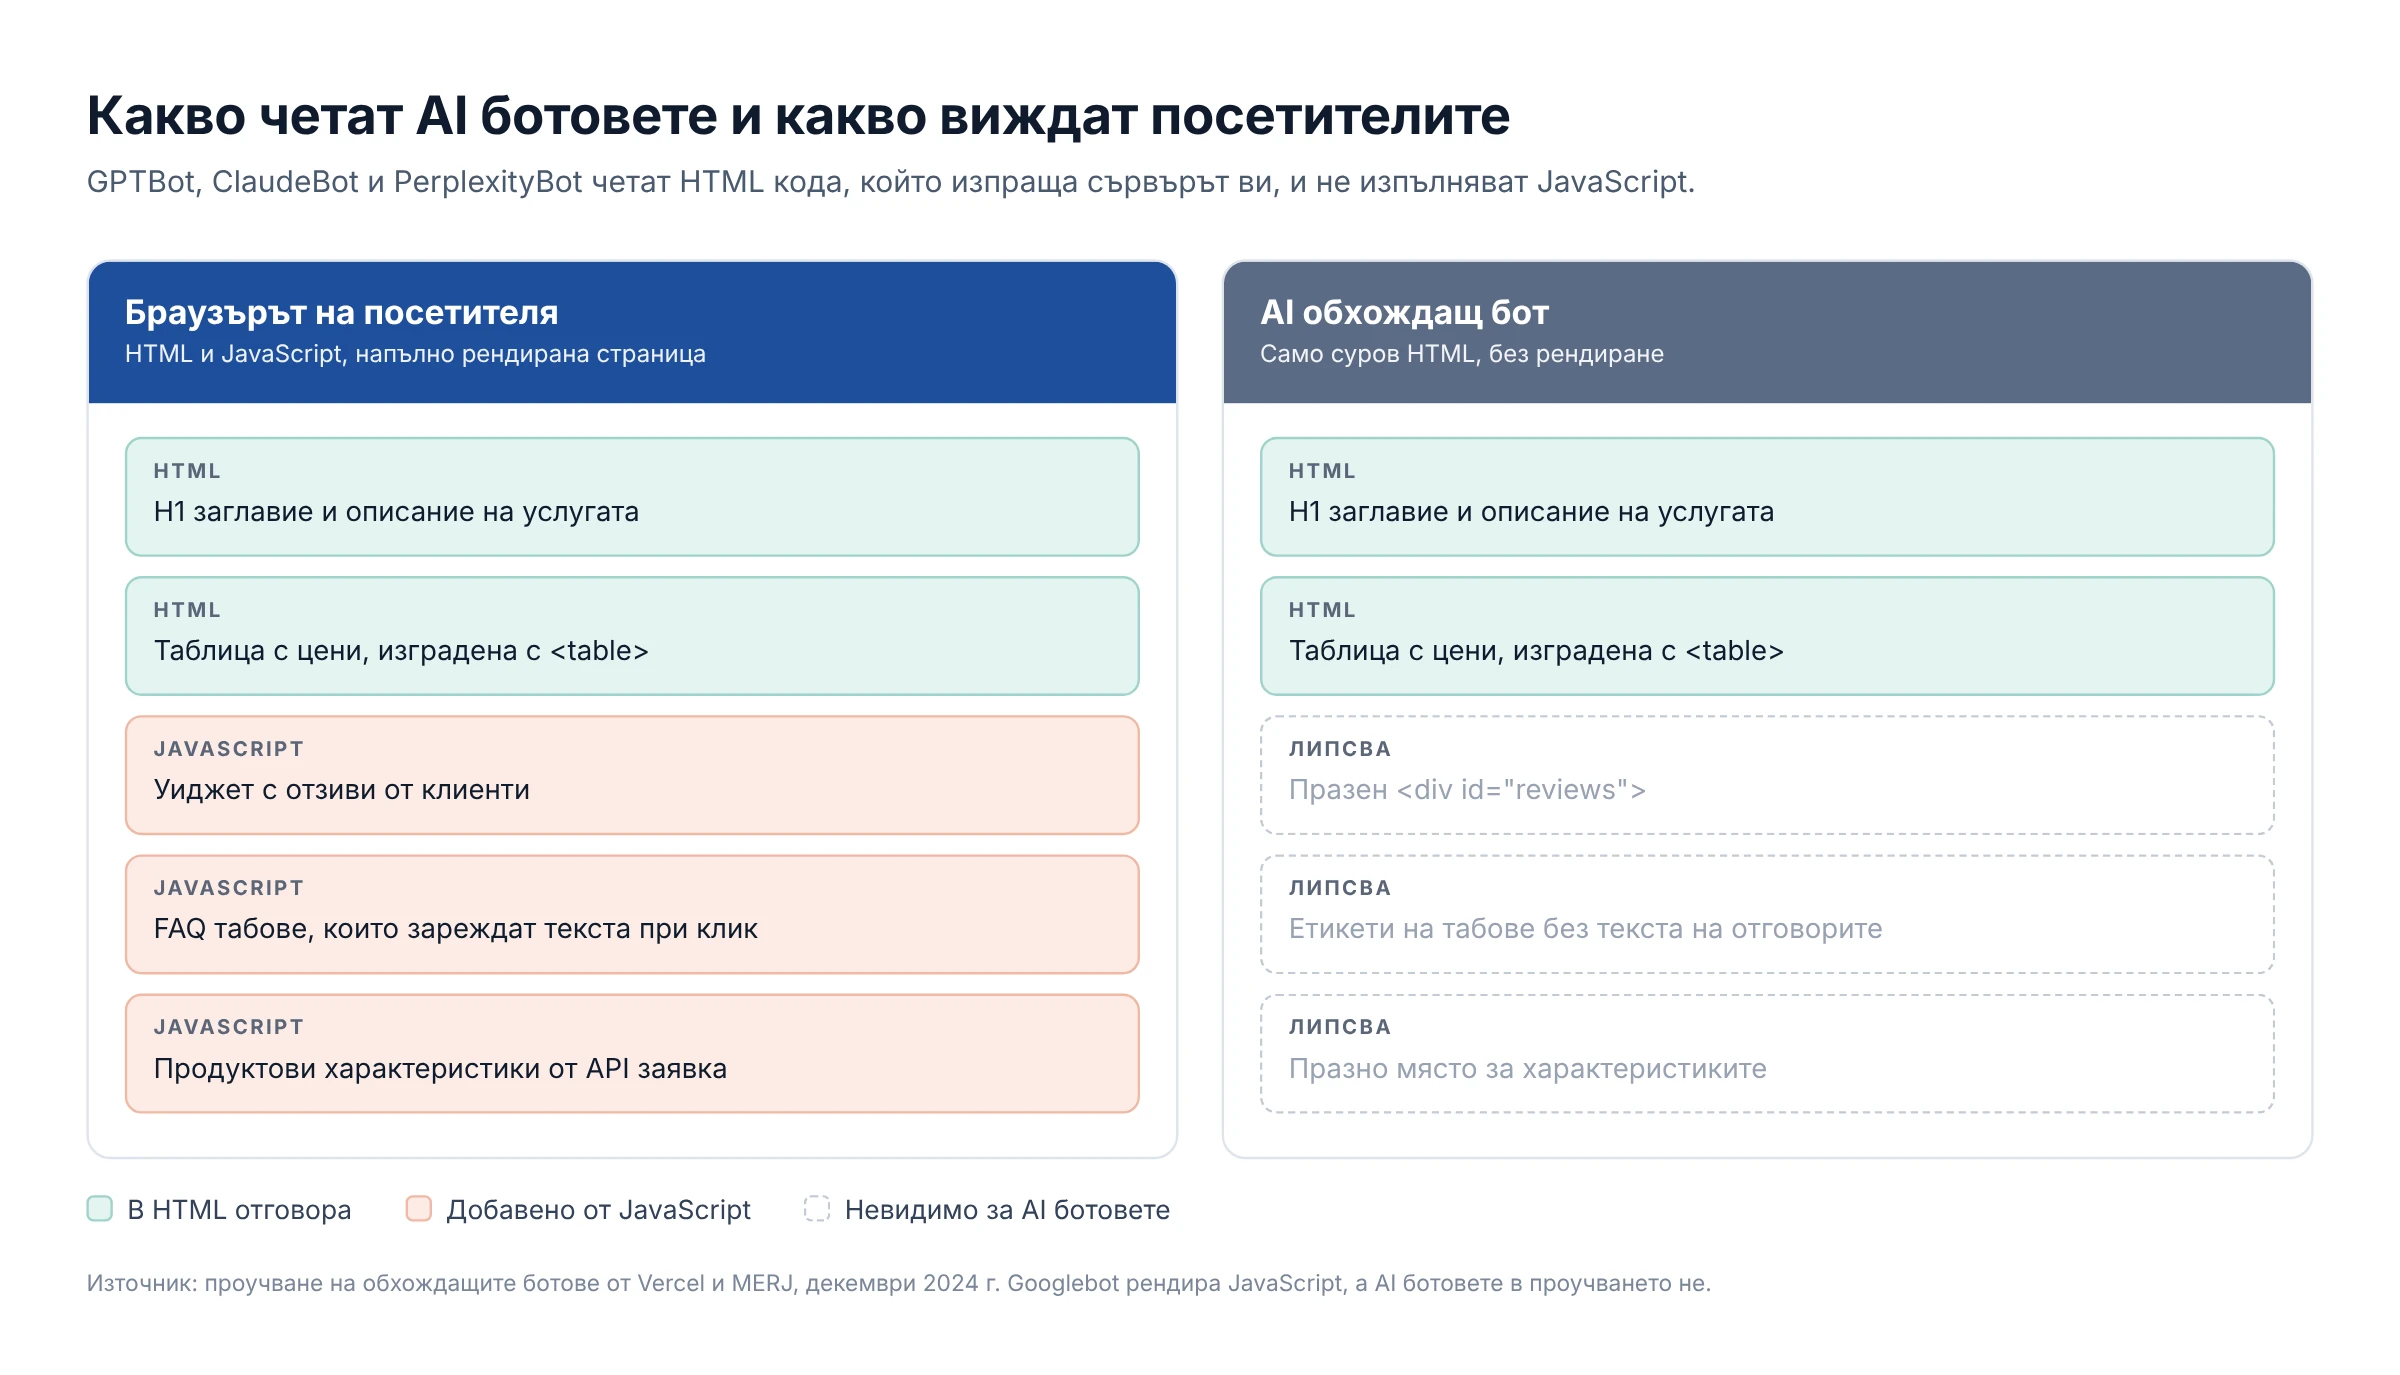
Има четири вида съдържание, които AI ботовете често пропускат:
- Съдържание, което JavaScript добавя след зареждането на страницата, например отзиви, уиджети с цени и страници в едностранични приложения (SPA)
- Съдържание в табове или акордеони, което се зарежда едва когато посетителят кликне (панелите, чийто текст вече е в HTML кода и само е скрит с CSS, остават четими)
- Съдържание в изображения, например графики с цени или инфографики без HTML версия
- Съдържание зад вход в акаунт, банери за бисквитки или изскачащи прозорци, които заменят HTML кода на страницата
Работи обикновеният HTML: заглавие, абзац, списък или HTML таблица, които сървърът ви изпраща още с първия отговор.
За да тествате страница, отворете изходния ѝ код (View Source: Ctrl+U в Chrome на Windows, Cmd+Option+U на Mac) и потърсете ключово изречение, цена или продуктова характеристика. Ако текстът го няма в изходния код, AI ботовете не могат да го прочетат. Решението е рендиране на сървъра (server-side rendering) или статичен HTML за основното съдържание, а JavaScript да остане за допълнения като чат уиджети.
Ако посетителят вижда дадено изречение, но в изходния код то го няма, AI ботовете също няма да го намерят.
Трябва ли да блокирате AI ботовете за обучение?
Допуснете AI ботовете за търсене и тези по заявка на потребител, ако искате AI асистентите да могат да цитират страниците ви. За ботовете за обучение решете според това как бизнесът ви печели от съдържанието си. Три условия променят отговора:
- Ако съдържанието ви е там, за да носи клиенти за услуга или продукт, блокирането на ботовете за обучение защитава малко. Ако ги допуснете, публичните ви страници остават в данните, от които се учат бъдещите модели.
- Ако продавате самото съдържание, например платени проучвания, курсове или новини, блокирането на GPTBot, ClaudeBot и Google-Extended пази бъдещото ви съдържание извън обучението на моделите на тези компании.
- Ако сайтът ви е зад Cloudflare, блокирайте обучението с правила за конкретни ботове, а не с категорията Training, защото блокирането на Training в Cloudflare спира и Googlebot.
Решението е търговско, а не техническо: с robots.txt можете едновременно да блокирате обучението и да запазите шанса си да бъдете цитирани.
Блокирането на бот за обучение не ви изважда от AI търсенето. OpenAI описва GPTBot и OAI-SearchBot като независими настройки, а Google посочва, че Google-Extended не влияе на индексирането и класирането в Google Search. За да ограничите как AI функциите на Google използват дадена страница, Google препоръчва nosnippet, data-nosnippet, max-snippet и noindex. Те обаче променят и начина, по който страницата се показва в обикновените резултати.
Ето примерен robots.txt, който блокира основните ботове за обучение и допуска AI търсенето:
# Обучение на AI: блокирано
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /
# AI търсене и ботове по заявка на потребител: разрешено
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Allow: /
# Всички останали ботове
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://yourdomain.com/sitemap.xml
Какво питат собствениците на сайтове за достъпа на AI ботове?
В: Ако блокирам GPTBot, изчезва ли сайтът ми от търсенето в ChatGPT?
О: Не. GPTBot е свързан с обучението на моделите на OpenAI, а OAI-SearchBot определя дали страниците ви се показват в отговорите на търсенето в ChatGPT. OpenAI описва двата бота като независими настройки.
В: След колко време промяна в robots.txt стига до ChatGPT и Perplexity?
О: След около 24 часа. Според OpenAI търсенето в ChatGPT се съобразява с промяна в robots.txt за около 24 часа, а Perplexity посочва до 24 часа.
В: Контролира ли Google-Extended AI Overviews?
О: Не. Google-Extended управлява обучението и grounding на Gemini в приложенията на Gemini и във Vertex AI. AI Overviews използват индекса на Googlebot, а инструментите на Google за тях са nosnippet, data-nosnippet, max-snippet и noindex.
В: Спира ли robots.txt всички AI ботове?
О: Не. robots.txt е доброволен стандарт. Според OpenAI правилата в robots.txt може да не важат за ChatGPT-User, а Perplexity посочва, че Perplexity-User по принцип игнорира robots.txt. Затова само правило в защитната стена може наистина да наложи блокирането.
В: Ще получа ли повече трафик, ако допусна AI ботовете?
О: Не само по себе си. Когато допуснете AI ботовете, страниците ви могат да бъдат прочетени и цитирани. Дали AI асистентът ще цитира дадена страница, зависи от въпроса, от другите страници по темата и от самото съдържание.