Управляем клъстър хостинг: Висока наличност без ентърпрайз цена

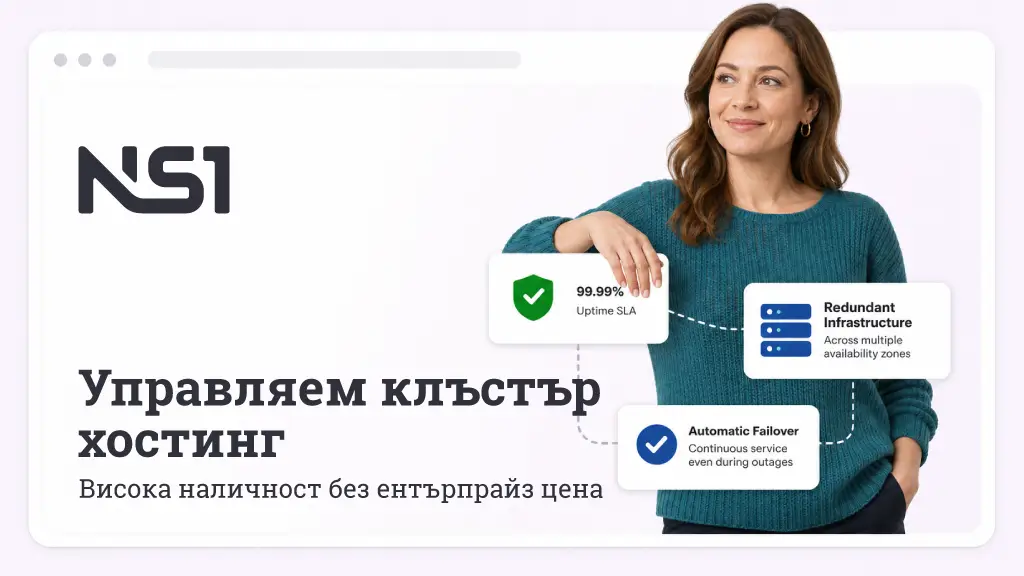
Управляемият клъстър хостинг поддържа вашия уебсайт онлайн, дори когато един сървър има проблем, защото предоставя няколко машини в единна система. Ролите за уеб, мейл, датабази DNS споделят дисково пространство през NFS (Network File System), MariaDB Galera репликира всеки запис към node-овете, а MaxScale маршрутизира заявки за датабазата към здрав node.
На управляемите планове на NS1 техническият екип предоставя клъстера според формата, която поискате, а страницата Cluster Management в SPanel докладва “здравето” на всеки node в реално време. Получавате висока наличност и място за мащабиране чрез добавяне на сървъри – без сами да изграждате failover plumbing-а.
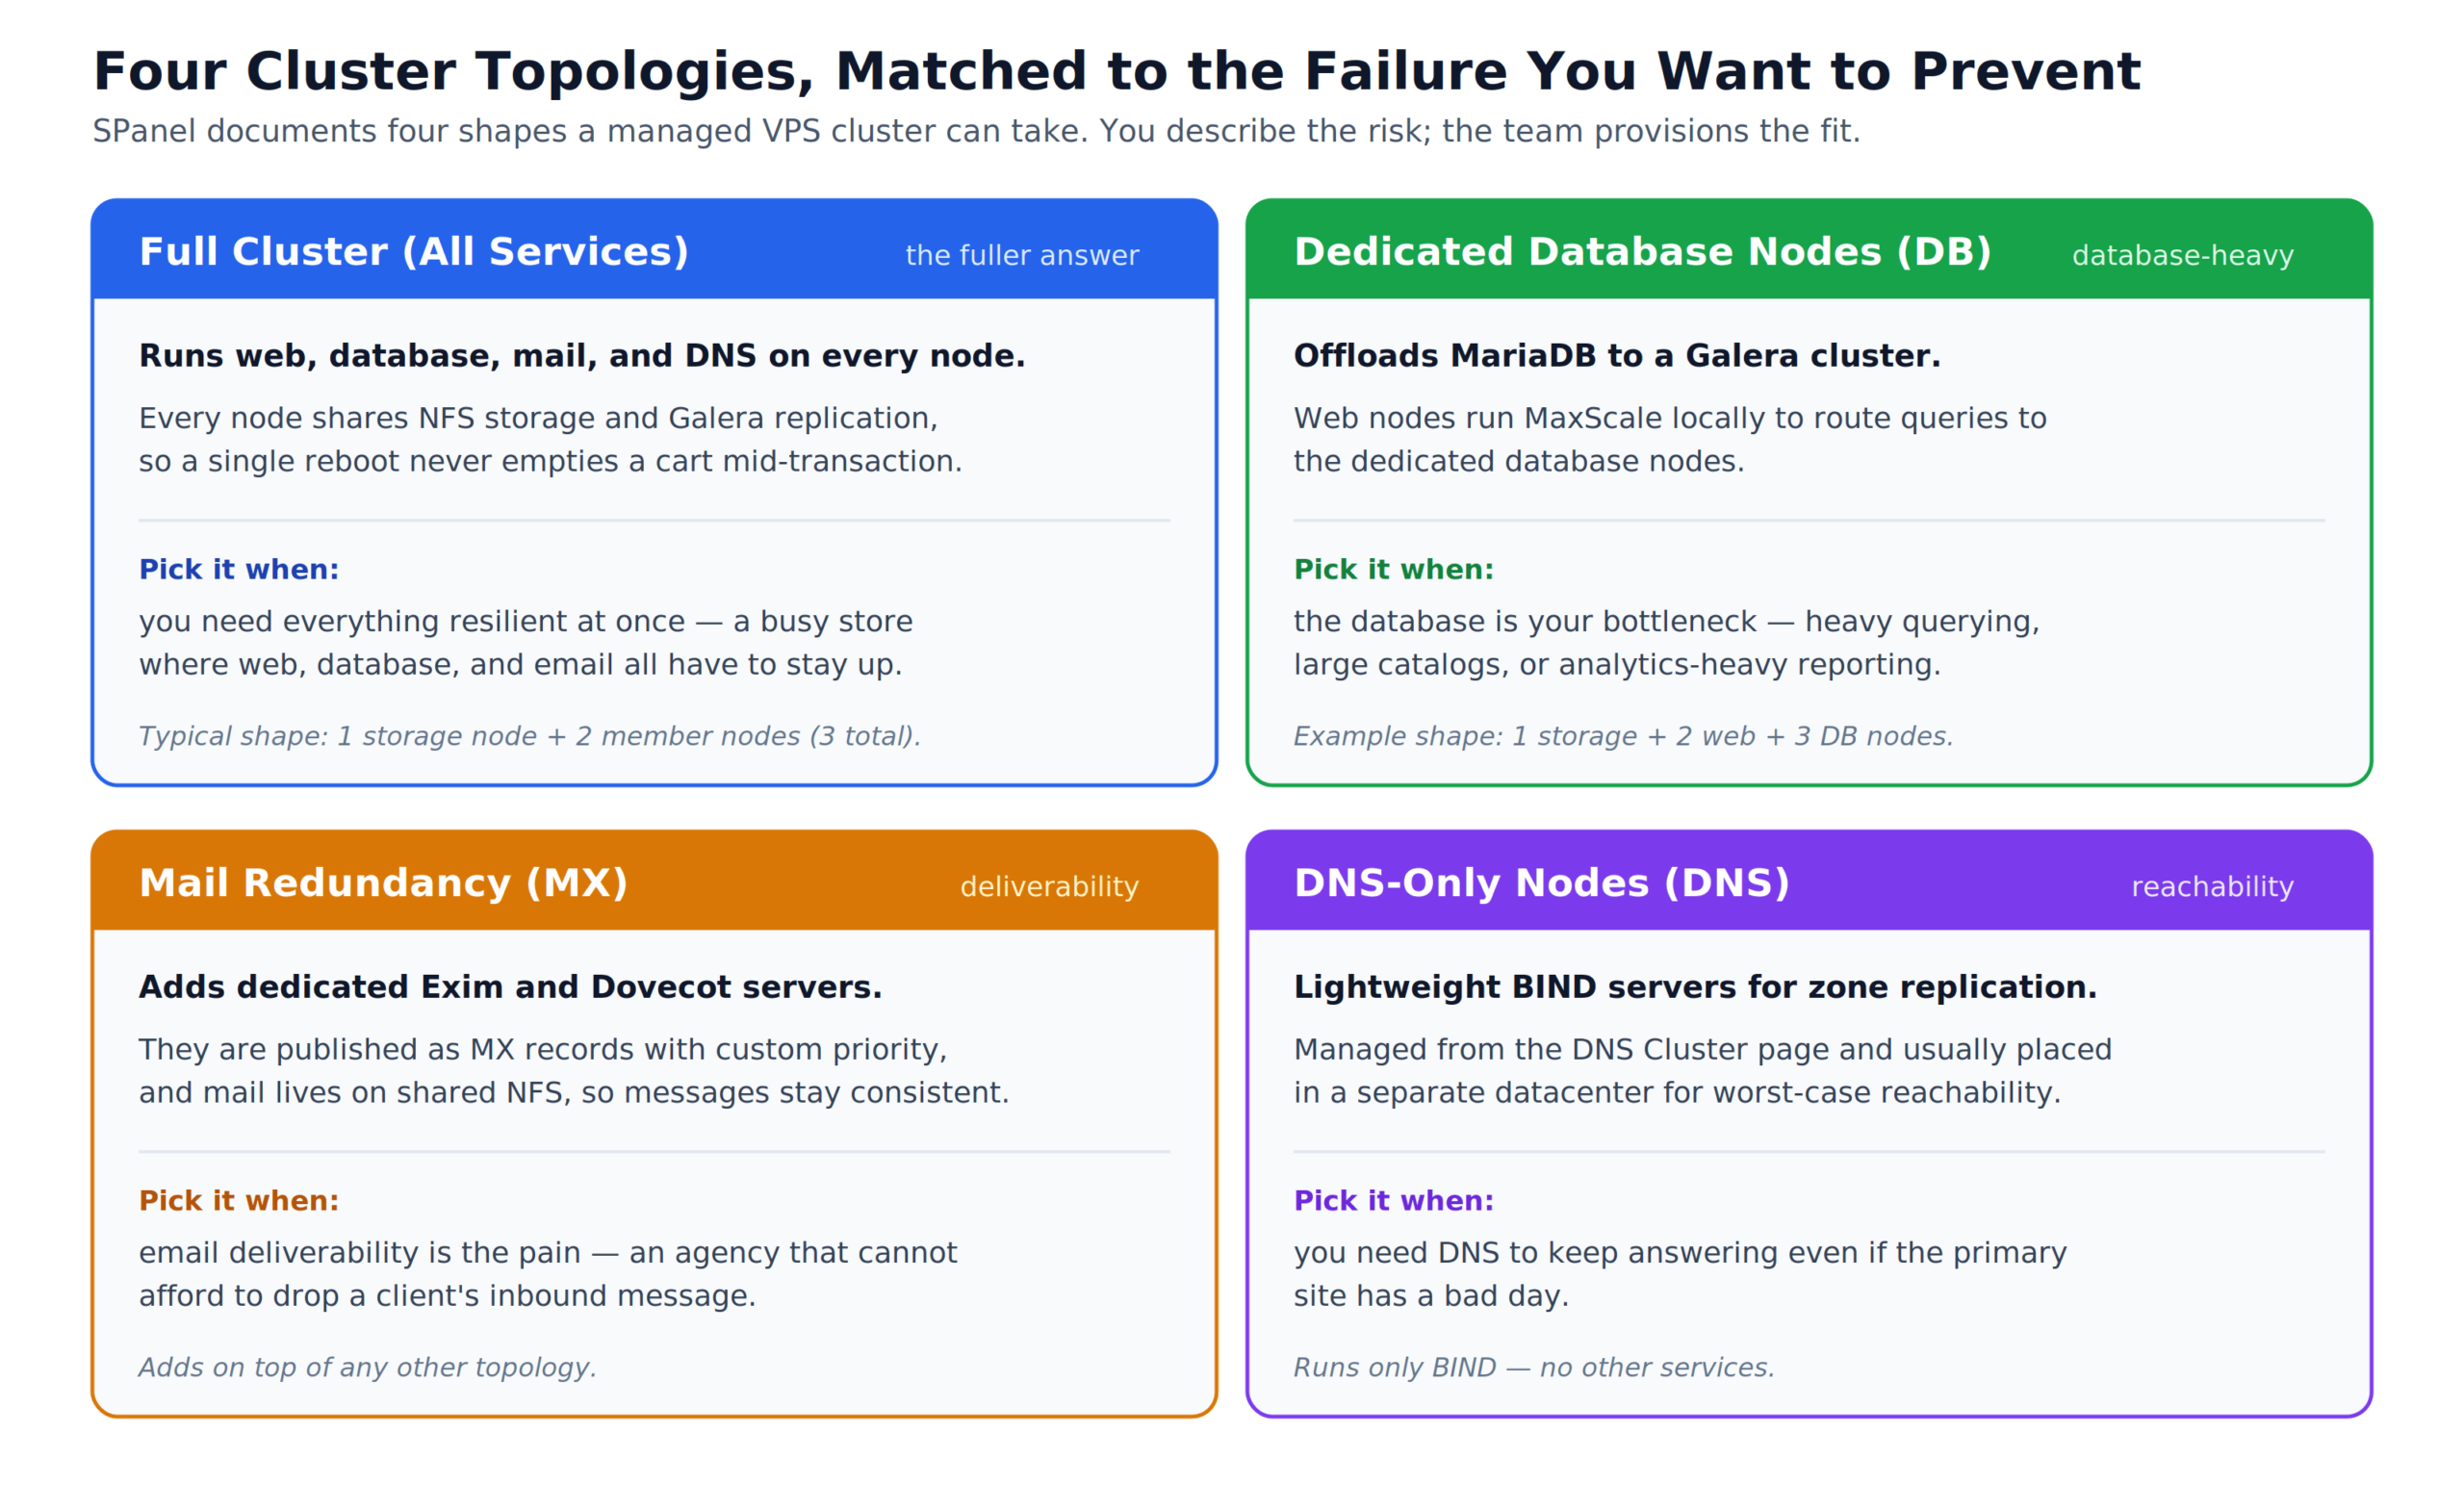
- SPanel документира четири топологии: Mail Redundancy (MX), DNS-Only Nodes (DNS), Dedicated Database Nodes (DB) и Full клъстър (All Services).
- Страницата Status & Health показва клъстър Nodes, NFS Storage, MariaDB Galera клъстър и DNS Servers, плюс табове Nodes, Services и Activity Log.
- Промените в топологията минават през техническия екип на NS1, а не през бутон в панела.
- Високата наличност намалява downtime-а на единичен сървър. Не замества бекъпите и няма да ви спаси от грешка на ниво приложение.
Един сървър означава единична точка за възможни проблеми.
Когато се рестартира за пач, дискът му се развали или се натъкне на процес, който не може да реализира, всички сайтове върху него ще минат офлайн. За онлайн магазин, който приема поръчки ежеминутно, или агенция, която хоства четиридесет клиентски сайта, този час означава загубени приходи и купчина тикети. Управляемият клъстър хостинг премахва този проблем като свързва няколко сървъра в синхронизирана мрежа.
Ето как работи този модел и как може да е полезен на вашия онлайн проект.
Защо работата на един сървър крие рискове
Когато хостваме личен блог, случаен проблем със сайта е просто досаден. Но за инфраструктура, която генерира приходи, това може да струва скъпо.
Стандартът в индустрията за SLA uptime от 99.9% означава приблизително 8.7 часа downtime годишно. Ако този процент нарасне до 99.99%, downtime-a намалява до около 52 минути. NS1 гарантира 99.9% uptime на своите напълно управляеми VPS планове, а клъстерът е начинът да надхвърлите тавана на една машина към по-високия край на този диапазон.
Високата наличност преди време идваше и със сериозна цена: специалист, който да свърже репликация и load balancing, или платформа, която таксува на компонент. Управляемият клъстер дава на клиентите на NS1 същата идея – няколко сървъра, действащи като един – но без тежки удари по бюджета.
Какво е управляем клъстър хостинг?
Управляемият клъстър хостинг разпределя уебсайта ви върху множество сървъри, така че проблемът на една машина да не свали целия сайт. Той се изгражда върху три елемента: споделен NFS storage node, който сервира едни и същи файлове на всеки сървър, MariaDB Galera репликация, която държи всяко копие на базата данни идентично, и MaxScale query routing, който изпраща всяка заявка към здрав database node. Вие определята подходящата формация за вашия проект, NS1 я предоставя, а SPanel докладва здравето на всеки node.
Капацитетът расте по същия начин, по който расте устойчивостта – чрез добавяне на node-ове, а не чрез миграция към по-мощен сървър.
Високата наличност не е същото като „винаги онлайн“
Първото погрешно схващане е, че високата наличност означава, че сайтът никога не пада.
Клъстерът просто премахва проблемите свързани с хостването на единичен сървър. Той не може да се справи с проблемни deploys, изтекли SSL сертификати или плъгин, който “бута” сайта ви.
Втората грешка е да се третира репликацията като бекъп. Репликацията копира лайв данните навсякъде мигновено – включително лош DELETE. Клъстерът отговаря на един въпрос: сайтът все още ли работи? Бекъпът отговаря на друг: мога ли да върна работещо копие от миналия вторник? Сериозните сайтове се нуждаят и от двете.
Как работи управляем VPS клъстер
Представете си ресторант с голяма кухня и редица готвачи: ако един готвач се обади, че е болен, това не налага целия ресторант да спре да работи. Кухнята е storage node-ът, който сервира /home на всеки член през NFS, така че всички сървъри четат едни и същи файлове. Всеки member node пуска пълния стак от услуги.
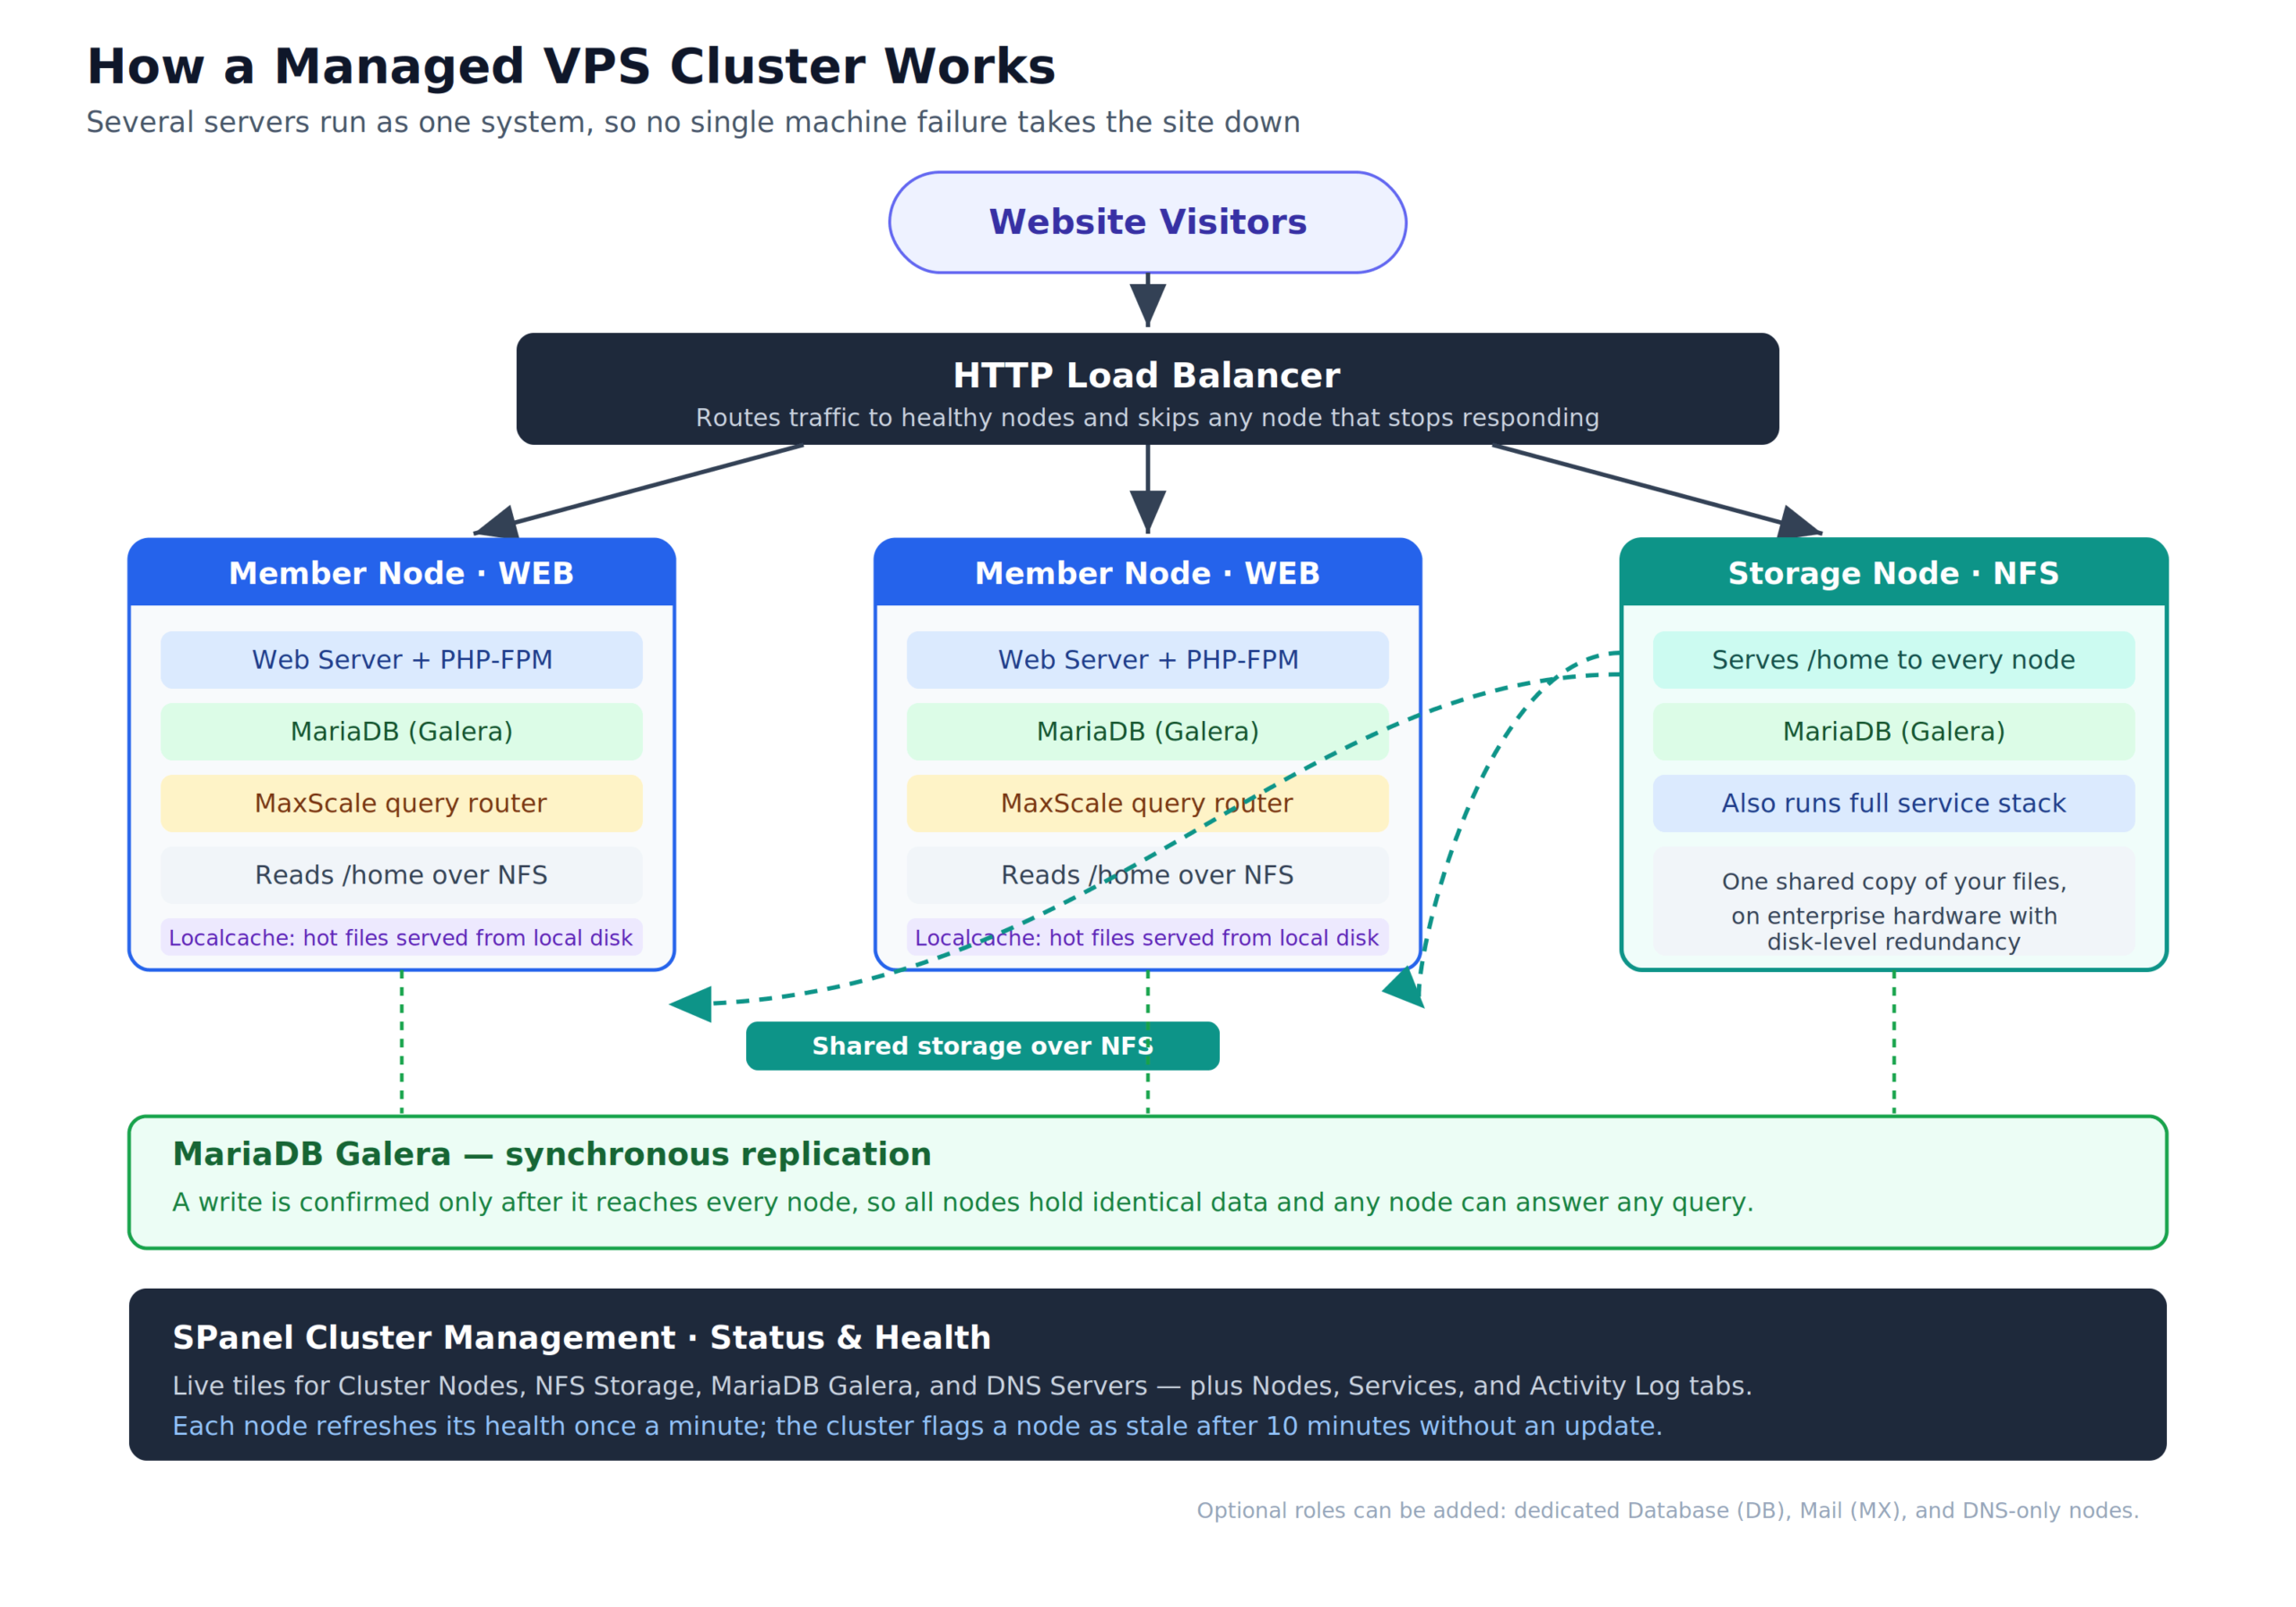
Ролите в клъстера решават кой какво прави. Web nodes сервират трафик зад HTTP load balancer, mail node обработва имейлите и е публикуван в MX записите ви, а database node приема заявки през MaxScale.
Отдолу MariaDB работи с Galera репликация, така че write функция на един node достига до останалите. Тъй като тази репликация е синхронна, write се потвърждава само след като всеки node го има. Това е, което позволява на всеки node безопасно да отговори на всяка заявка. Web nodes също кешират пътища от споделеното дисково пространтство на локален диск, където последователните четения работят до 60× по-бързо, отколкото през NFS.
Акаунти, домейни и системни потребители остават синхронизирани в целия клъстер, така че ако един node се провали, сайтът стои лайв на останалите. Failover е бърз: database слоят пренасочва в рамките на секунди – обикновено преди посетител да забележи – а load balancer-ът спира да изпраща нов трафик към всеки node.
Четирите клъстер топологии, които SPanel поддържа
Cluster Management се намира в админ зоната на SPanel с два записа: Status & Health и DNS Cluster. Отворете Status & Health и намерете SPanel Cluster Infrastructure. Тази страница документира четири топологии на прост език.
Като основно правило, винаги съобразявайте топологията с проблема, който се опитвате да предотвратите.
- Mail Redundancy (MX) добавя dedicated Exim и Dovecot сървъри като MX записи с персонализиран приоритет, с mail на споделено NFS.
- DNS-Only Nodes (DNS) са леки BIND сървъри за репликация на зони, управлявани от страницата DNS клъстър.
- Dedicated Database Nodes (DB) разтоварват MariaDB към Galera клъстер, докато web nodes пускат MaxScale локално, за да маршрутизират заявки.
- Full клъстър (All Services) пуска web, database, mail и DNS на всеки node, споделяйки NFS storage и Galera репликация.
Как да мониторирате здравето на клъстера в SPanel
Summary tiles покриват Cluster Nodes – с брой „N online · N stale“ – плюс NFS Storage, MariaDB Galera клъстър и DNS Servers. Табът Nodes докладва load, disk, memory, replication и status на всеки член; табътът Services следи всяка услуга от Web Server и PHP-FPM до MariaDB, MaxScale, mail, BIND, NFS и Firewall; а Activity Log носи филтър по severity.
Всеки node обновява “здравето си” веднъж в минута, а клъстерът маркира един node като stale след 10 минути без актуализация – така ще видите евентуален проблем в dashboard-а си много преди да той да нанесе щети.
Едно предупреждение е важно тук. Този екран е само за мониторинг и здраве. Добавянето на node-ове или промяната на топологията минава през техническия екип на NS1, който предоставя клъстера. Това е управляем-service модел, а не самоуправляем от страна на клиента.
Как изглежда управляем клъстер на практика
Шели управлява натоварен WooCommerce магазин и рискът ѝ е от повреда на checkout по време на разпродажба. Full клъстър държи web, database и mail работещи върху няколко node-а, така че единичен reboot да не изпразва количка в средата на транзакция. А когато дойде разпродажба, капацитетът расте чрез добавяне на node, вместо да се залага на един сървър, който държи цялата информация.
Агенция, която хоства клиентски сайтове, има различен проблем за решаване: email deliverability. Mail Redundancy добавя dedicated Exim и Dovecot сървъри, публикувани като MX записи с персонализиран приоритет, и тъй като mail живее на споделено NFS, съобщенията остават последователни, независимо кой node ги приема. Ако главният мейл сървър е недостъпен, изпращащите сървъри просто преминават към следващия MX запис.
Управляем клъстър vs. DIY vs. Eдиничен сървър
Сравнението е структурно – какво получавате срещу какво продължавате да поддържате сами.
| Какво получавате | Управляем клъстър | Do-It-Yourself | Единичен сървър |
|---|---|---|---|
| Оцелява при провал на един съървър | Да, върху member nodes | Само ако го изградите | Не |
| Споделен storage върху nodes | NFS, предоставено за вас | Вие го конфигурирате и поддържате | Не е приложимо |
| Репликация на датабазата | MariaDB Galera, управляем | Вие инсталирате и настройвате Galera | Единична база данни |
| Query routing | MaxScale, конфигуриран за вас | Вие деплойвате MaxScale сами | Няма |
| Мониторинг на здравето | Вграден в SPanel | Вие сглобявате свой | Основен, на сървър |
| Кой поправя счупен node | Техническият екип на NS1 | Вие | Вие |
Екип може да изгради всичко това на самоуправляем сървъри, но тогава всеки слой е техен за поддръжка. Тази разлика е точно какво всъщност означава управляем хостинг на практика.
Какво не може да направи клъстър хостинга
Клъстерът не е универсално решение за всички проблеми с уеб хостинг услугите. Например, не замества бекъпите – репликацията разпространява грешка толкова бързо, колкото и добрите данни, така че поддържайте независими бекъпи и извън клъстера.
Клъстерът не поправя грешки на приложението, тъй като код, който се проваля, ще се провали на всеки node. И няма да спаси сайт от пробив сам, затова мониторингът на сигурността в реално време все още има значение. За да помогне с последното, SShield работи на всеки node и блокира 99.998% от web атаките, преди да достигнат сървъра ви.
Има я и границата на управляемат услуга: промените в топологията минават през техническия екип, а не през бутон в панела. За повечето бизнес собственици това е плюс – експерт върши рисковата част. За екип, който иска контрол на ниво бутон, това е реален компромис, който си струва да се назове предварително.
Как да изберете правилната клъстер настройка
Започнете с проблема, който действително се опитвате да предотвратите, след което работете назад към решението:
- Назовете риска. Outage на checkout ли е проблема, изпуснат клиентски имейл, база данни, която се огъва под натоварване, или домейн, който трябва да остане достъпен каквото и да стане?
- Съобразете топология с него. Mail Redundancy за deliverability, Dedicated Database Nodes за ботълнек в датабазата, DNS-Only Nodes за достъпност или Full клъстър, когато всичко трябва да остане устойчиво наведнъж.
- Говорете с техническия екип. Опишете средата, от която се нуждаете, а техническият екип проектира и предоставя клъстера около вашите трафик нужди и изисквания за резервираност.
- Поддържайте независим бекъп график. Клъстерът защитава uptime; бекъпите защитават срещу грешки.
- Използвайте Status & Health като ежедневна проверка. Сканирайте за stale members и събития с по-висока важност в Activity Log, преди да се превърнат в тикети към поддръжката.
Готови ли сте за следващата сттъпка? Говорете с нашия технически екип за това как би изглеждал управляем VPS клъстер за вашата настройка.
Често задавани въпроси
В: Какво е управляем VPS клъстер?
О: Управляем VPS клъстерът представлява няколко сървъра, работещи като една хостинг система. Те споделят /home през NFS, репликират базата данни с MariaDB Galera и маршрутизират заявки през MaxScale, с роли на членове за web, mail, database и DNS. Целта е висока наличност – сайтът остава лайв, когато един сървър се се срещне с проблем – плюс мащабиране чрез добавяне на допълнителни машини.
В: Замества ли клъстерът бекъпите?
О: Не. Репликацията държи лайв данните ви идентични върху nodes, което също означава, че копира грешки мигновено – лош delete или криптиран файл се разпространява навсякъде наведнъж. Клъстерът отговаря на въпроса „сайтът все още ли е наличен?“, докато бекъпите отговарят на „мога ли да възстановя сайта от миналата седмица?“. Поддържайте point-in-time бекъпи извън клъстера.
В: Мога ли да добавям клъстер nodes сам в SPanel?
О: Не и в shipping продукта. Страницата Cluster Management е за мониторинг; добавянето на nodes или промяната на топологията минава през техническия екип на NS1. Описвате промяната, от която се нуждаете, ние я предоставяме, а панелът след това показва статуса на всеки node в реално време. Това е управляем, а не self-service – по дизайн, защото операциите с клъстер са твърде значими, за да бъдат изложени на случайни грешки.
В: Какви клъстер топологии поддържа SPanel?
О: Имате на разположение, именувани на страницата Status & Health. Mail Redundancy (MX) добавя dedicated Exim и Dovecot mail съървъри. DNS-Only Nodes пускат BIND за репликация на зони. Dedicated Database Nodes разтоварват MariaDB към Galera клъстер с MaxScale маршрутизация. Full клъстър (All Services) пуска всяка услуга – web, database, mail и DNS – на всеки node.
В: Как да проверя здравето на клъстера си?
О: Отворете Cluster Management, след това Status & Health. Ще видите Cluster Nodes, NFS Storage, MariaDB Galera клъстър и DNS Servers. Под тях табът Nodes докладва load, disk, memory, replication и status на всеки съървър; табът Services следи всяка работеща услуга; а Activity Log записва събития с филтър по важност. Здравето на node се обновява всяка минута.
В: Колко бързо се възстановява клъстерът от провал на node?
О: Обикновено в рамките на секунди. Galera открива провален database node почти мигновено и продължава да приема записи, стига мнозинството от node-овете да останат онлайн; MaxScale спира да маршрутизира заявки към сваления node; а load balancer-ът пренасочва нов уеб трафик към “здравите”. Когато node-ът се върне онлайн, той се ресинхронизира и се присъединява автоматично към клъстер системата.
В: Ще се зарежда ли уебсайтът ми по-бързо на клъстер?
О: Не автоматично. Клъстерът предоставя капацитет и надеждност, а не чиста скорост на единична заявка – обработва повече едновременни посетители и оцелява при проблеми. Високопроизводителен единичен VPS сървър може да сервира отделна страница точно толкова бързо. Read-heavy сайтове могат да спечелят от localcache, който сервира файлове от локален диск, но това е отделно подобрение.
В: Какъв е най-малкият практичен клъстер?
О: Три nodes. Два е технически възможно, но три е минимумът, който запазва кворум на датабазата и следователно продължава да приема writes, ако един node отпадне. Клъстерите започват да оправдават цената си, когато резервираността или капацитетът наистина оправдават пускането на повече от една машина.
В: Високата наличност само за големи компании ли е?
О: Вече не. Преди изискваше специалист или платформа, която таксува на компонент. На управляемите планове на NS1 клъстерът се предоставя от техническия екип и се мониторира вътре в SPanel без такса на функция, така че малък магазин или агенция може да се възползва без да плаща прекалено високи цени.