Един VPS сървър или клъстер: Кога бизнесът ви трябва да премине към хоризонтално мащабиране?

Преминаването от един VPS сървър към клъстер има смисъл тогава, когато цената на един час downtime е по-висока от инвестицията в допълнителните сървъри, или когато една машина вече не може да се справи с натоварването в най-активните ви дни.
Всъщност това е най-основното ви решение.
Повечето сайтове никога не достигат до този момент. Един добре конфигуриран и надеждно архивиран сървър без проблем обслужва огромната част от натоварванията. Но когато срив на ядрото в 2 през нощта означава загубени поръчки, а не просто неприятно утро за администратора, тогава сметката вече изглежда различно.
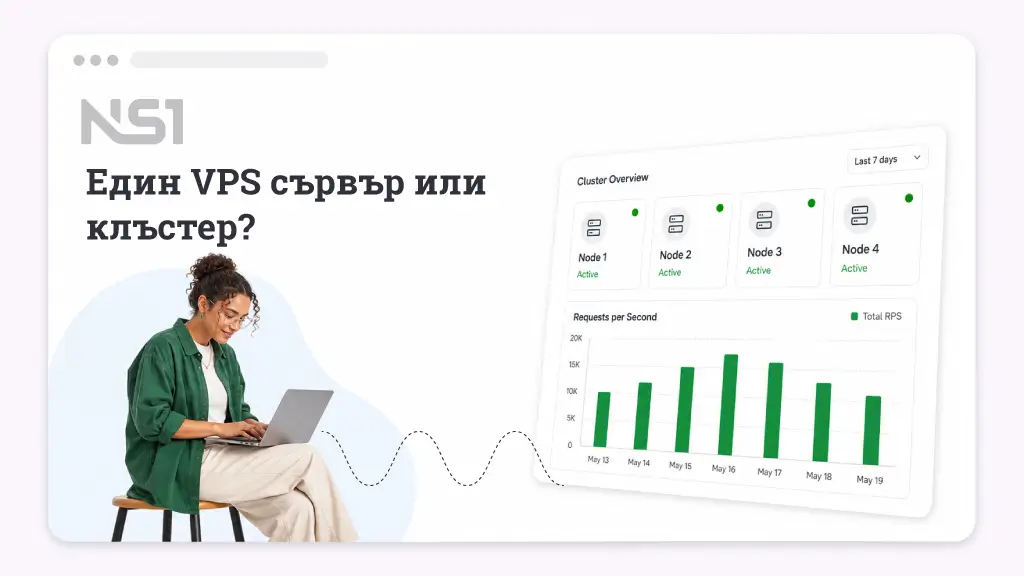
Клъстерът разпределя сайтовете ви между няколко сървъра, които използват общо пространство за съхранение на данните. Така, ако един от тях отпадне, останалите продължават да обслужват посетителите без прекъсване. С услугата Managed Cluster Hosting от NS1, нашият екип проектира и изгражда архитектурата според нуждите на вашия проект, а SPanel предоставя информация в реално време за състоянието и здравето на всички nodes в клъстера.
Три важни неща, които трябва да знаете
- Един VPS сървър остава правилният избор за повечето сайтове. Преминавайте към клъстер само когато имате нужда от по-висока надеждност или по-голям капацитет, а не заради престиж.
- Клъстерът не прави сайта по-бърз. Той увеличава капацитета и устойчивостта при отказ, но не намалява времето за зареждане на една отделна страница.
- Управлението на клъстерната инфраструктура се извършва от техническия екип на NS1. Вие наблюдавате състоянието през контролния панел, а всички промени по инфраструктурата се изпълняват от нас.
Кога един сървър все още е правилният избор
Останете на един VPS сървър, ако сайтът ви спокойно се побира в неговите ресурси и кратък downtime няма да доведе до сериозни загуби.
Фирмен сайт, блог, портфолио, локален бизнес или онлайн магазин с няколкостотин поръчки седмично могат безпроблемно да работят на един управляван VPS. В подобни случаи средствата са по-добре инвестирани в развитието на бизнеса, отколкото в по-сложна инфраструктура.
Най-лесният начин да прецените е да изчислите цената на downtime-a.
Стандартният SLA с 99.9% uptime означава приблизително 8.7 часа недостъпност годишно. При 99.99% uptime това време намалява до около 52 минути годишно.
Ако 8.7 часа недостъпност през най-натоварените ви периоди струват по-малко от инвестицията в клъстерна инфраструктура, тогава един сървър остава най-разумното решение. Ако загубите са по-големи – вече имате причина да преминете към клъстер.
Вторият важен фактор е капацитетът.
Когато процесорът, паметта или дисковата система редовно работят близо до максималните си стойности през обикновена работна седмица (а не само по време на Black Friday), следващият пик в трафика може да доведе до сериозни проблеми.
Ако ограничението е чисто изчислителната мощност, а не надеждността, преминаването от VPS към Cluster Hosting често е най-логичната следваща стъпка.
Какво всъщност решава един клъстер
Най-разпространеното погрешно схващане е, че клъстерите ускоряват сайтовете.
Не е така.
Всяка отделна заявка продължава да се обработва от един конкретен node и със скоростта, която той може да осигури. Ако дадена страница е бавна заради неоптимизирани SQL заявки, липса на кеширане или неефективна тема на WordPress, тя ще бъде също толкова бавна и в клъстерна среда.
Първо оптимизирайте приложението.
Клъстерът увеличава мащабируемостта на вече съществуващата производителност – независимо дали тя е добра или лоша.
Кои проблеми решава клъстер хостинга:
- Премахва единичните точки на отказ. Ако един node отпадне, останалите продължават да обслужват сайта.
- Позволява хоризонтално разширяване. Вместо да мигрирате към все по-мощен сървър, просто добавяте нови nodes.
- Улеснява географското разпределение. При инфраструктура с няколко датацентрове, копия на средата могат да бъдат разположени в различни региони, така че посетителите да бъдат обслужвани от най-близката локация.
Друго широко разпространено погрешно схващане е, че преминаването към клъстер изисква ръчно пресъздаване на всички акаунти и сайтове.
Не е така.
Акаунтите, домейните и системните потребители се синхронизират автоматично между всички nodes, така че няма отделни копия на всеки сайт, които да трябва да се поддържат ръчно.
Как работи Managed Cluster Hosting
Клъстерът представлява няколко сървъра, които функционират като една обща хостинг среда. Зад това стоят три основни технологии, които осигуряват надеждност, синхронизация и висока производителност.
- Общото хранилище поддържа файловете напълно идентични
Един от node-овете изпълнява ролята на Storage Node (сървър за съхранение на файловете). Той съдържа всички файлове на сайтовете и ги споделя към останалите nodes чрез NFS (Network File System).
Всеки останал сървър използва това споделено пространство като собствената си директория /home.
Това означава, че:
- файловете не се копират;
- няма процеси по синхронизация;
- съществува само едно копие на всеки файл.
Всички уеб сървъри четат и записват едни и същи данни.
Така се елиминира цяла категория потенциални проблеми. Ако качите изображение през един node, то е незабавно достъпно през всички останали, защото никога не е съществувало второ копие, което да трябва да бъде синхронизирано.
В общото хранилище се намират още:
- файловете на електронната поща;
- DNS зоните;
- SSL сертификатите;
- конфигурациите на виртуалните хостове.
От своя страна логовете, cron задачите и самата операционна система остават локални за всеки отделен сървър.
- MariaDB Galera поддържа базите данни синхронизирани
При базите данни подходът е различен.
Всеки node разполага със собствено локално копие на MariaDB. Изпращането на всяка SQL заявка през мрежата би довело до ненужно забавяне, затова базите работят локално.
За синхронизацията се използва Galera Cluster, който репликира всички записи синхронно. Това означава, че когато дадена операция по запис приключи успешно, информацията вече е записана на всички nodes в клъстера.
Galera използва и механизъм, наречен quorum. За да бъдат приемани нови записи, повече от половината nodes с бази данни трябва да могат да комуникират помежду си. Така се предотвратява т.нар. split-brain ситуация – сценарий, при който две отделени части на клъстера започват независимо да приемат записи и постепенно съдържанието им се разминава.
Именно поради тази причина три node-a са минималната практична конфигурация за Galera клъстер. При отпадане на един node останалите два продължават да формират мнозинство и системата функционира нормално.
- MaxScale насочва заявките към работещите nodes
MaxScale стои между приложението и сървърите с бази данни. Неговата задача е постоянно да следи кои nodes са в изправност и интелигентно да разпределя заявките.
Работата му е сравнително проста:
- всички операции по запис се изпращат към основния node;
- операциите по четене се разпределят между останалите сървъри.
Ако основният node отпадне, MaxScale автоматично избира нов, без апликацията да разбере, че е настъпила промяна. Благодарение на това обикновени приложения като WordPress могат да работят върху клъстер без никакви промени в конфигурацията си. WordPress се свързва само към един адрес, а маршрутизирането на заявките, балансирането на натоварването и автоматичното превключване при отказ се извършват изцяло от инфраструктурата.
Ролите на node-овете и четирите основни топологии
Не всеки сървър в клъстера изпълнява една и съща функция.
Някои nodes предоставят всички услуги едновременно – уеб сървър, база данни, поща и DNS. Други могат да бъдат специализирани само за една конкретна задача.
Например:
- отделен сървър само за MariaDB при магазини с голям брой заявки към базата;
- специализиран Mail Node, използван като резервен MX сървър;
- отделен DNS node, разположен в друг център за данни.
Комбинацията от тези роли формира четири основни типа клъстерна архитектура.
| Топология | Какво добавя | Подходяща за |
|---|---|---|
| Full Cluster (All Services) | Всеки node изпълнява всички услуги – Web, Database, Mail и DNS | Универсални натоварвания без ясно изразено тясно място |
| Dedicated Database Nodes | MariaDB работи на отделни сървъри, а MaxScale маршрутизира заявките от Web nodesте | Онлайн магазини, SaaS приложения и системи с много заявки към базата данни |
| Mail Redundancy (MX) | Добавят се специализирани Exim и Dovecot сървъри като резервни MX записи | Компании, за които електронната поща е критична услуга |
| DNS-Only Nodes | Леки BIND сървъри, разположени обикновено в друг дейта център | По-висока надеждност на DNS услугата при проблеми с основната инфраструктура |
Локално кеширане за сайтове с много операции по четене
Четенето на файлове през NFS неизбежно е по-бавно от достъпа до локален диск. За повечето сайтове тази разлика е практически незабележима. Но при WordPress сайтове, които непрекъснато зареждат едни и същи плъгини, теми и статични файлове хиляди пъти в секунда, натрупаното забавяне може да стане осезаемо.
Затова NS1 използва механизъм за локално кеширане.
При акаунти, при които това носи реална полза, определени директории с интензивно четене се копират върху локалния диск на всеки Web node. Всички останали файлове продължават да се обслужват от общото NFS хранилище. При последователно четене на кеширани файлове производителността може да достигне приблизително 60 пъти по-висока скорост спрямо директното четене през NFS. При типичните за един уебсайт малки файлове и произволни операции по четене подобрението обикновено е между 10% и 40%.
За всеки акаунт могат да бъдат кеширани до 30 директории, а синхронизацията между кеша и основното хранилище се извършва през предварително зададен интервал, който по подразбиране е пет минути.
ВАЖНО: Локалното кеширане на сайтове не се активира от потребителя чрез SPanel. Тя се настройва от техническия екип на NS1, когато анализът на натоварването покаже, че ще донесе реална полза.
Управление на клъстера чрез SPanel
Разделът Cluster Management в административния интерфейс на SPanel е мястото, откъдето следите състоянието на цялата клъстерна инфраструктура.
Началният екран Status & Health предоставя бърз преглед на всички основни компоненти чрез информационни панели, които показват:
- Общия брой nodes и колко от тях са онлайн;
- Състоянието на NFS хранилището;
- Статуса на MariaDB Galera клъстера;
- Състоянието на DNS сървърите.
По-подробната информация е организирана в три основни раздела.
Nodes
Тук се показва всеки node в клъстера със следната информация:
- hostname;
- IP адрес;
- роля;
- текущо натоварване;
- използвано дисково пространство;
- използвана RAM памет;
- състояние на репликацията;
- последна синхронизация;
- текущ статус.
Services
Този раздел показва състоянието на всички услуги на всеки отделен node, включително:
- Web Server;
- PHP-FPM;
- MariaDB;
- MaxScale;
- Exim;
- Dovecot;
- BIND;
- NFS;
- Firewall.
Така може лесно да се установи дали конкретна услуга работи нормално или изисква внимание.
Activity Log
Дневникът на събитията (activity log) съдържа цялата история на промените в клъстера:
- добавяне или премахване на nodes;
- промени в здравословното състояние;
- отказали услуги;
- конфигурационни промени.
Всички записи могат да бъдат филтрирани според тяхната важност.
В SPanel терминът Stale има конкретно значение. Всеки node изпраща информация за своето състояние веднъж в минута. Ако в рамките на десет минути не бъде получена нова информация, панелът маркира съответния node като Stale. Това не означава непременно, че сървърът е спрял да работи.
Причината може да бъде например:
- прекъсната cron задача;
- временен мрежов проблем;
- проблем с комуникацията между node-овете.
Независимо от причината, това е надежден индикатор, че съответният node трябва да бъде проверен.
Защо интерфейсът е само за наблюдение
Една от основните идеи зад управлението на клъстера е безопасността.
Поради тази причина интерфейсът е само за наблюдение. Няма бутон „Add Node“, както и възможност случайно да бъде премахнат node чрез погрешно натискане.
Всички операции по промяна на топологията се извършват от техническия екип на NS1. Вие определяте какво искате да постигнете, а инженерите изграждат и конфигурират необходимата инфраструктура. По този начин рискът от човешки грешки при работа с критична инфраструктура е сведен до минимум.
Сигурността също остава непроменена независимо от броя на node-овете.
SShield продължава да извършва мониторинг в реално време върху всеки сървър в клъстера по същия начин, както при стандартен VPS.
Един VPS сървър или клъстер – директно сравнение
| Характеристика | Един SPanel сървър | Managed Cluster |
|---|---|---|
| Работа при отказ на node | Един сървър означава една потенциална точка на пробив | Сайтовете продължават да работят върху останалите nodes |
| Увеличаване на капацитета | Чрез по-мощен сървър (вертикално мащабиране) | Чрез добавяне на нови nodes (хоризонтално мащабиране) |
| Файлова система | Локален диск | Единно NFS хранилище |
| Бази данни | Една MariaDB инстанция | Синхронна Galera репликация |
| Скорост на зареждане на една страница | Базова | Практически непроменена – увеличава се капацитетът, не скоростта |
| Цена и сложност | По-ниски | По-високи заради повече сървъри и по-сложна инфраструктура |
| Промени по архитектурата | Управлявате сами един сървър | Извършват се от техническия екип на NS1 |
| Най-подходящ за | Повечето сайтове със стабилен и предвидим трафик | Критични за бизнеса системи или приложения с много голямо натоварване |
Два реални примера за VPS сървър vs. Клъстер Хостинг
WordPress агенция с 50 клиентски сайта
Компания, която управлява около 50 WordPress сайта, използва клъстер от три пълнофункционални node-а, между които трафикът се разпределя равномерно.
При традиционен сървър един хардуерен проблем би свалил всички 50 сайта едновременно и би довел до десетки обаждания от клиенти. При клъстерната архитектура същият хардуерен отказ единствено намалява наличния капацитет с около една трета.
Сайтовете продължават да работят без прекъсване, а потребителите дори не разбират, че е възникнал проблем.
WooCommerce магазин с оборот от 1 милион долара месечно
Вторият пример е голям WooCommerce магазин с месечен оборот около 1 милион долара. При него архитектурата е значително по-специализирана:
- един Storage Node;
- два Web node-а;
- три MariaDB node-а;
- отделен Mail Node;
- два DNS node-а, разположени в различен център за данни.
В този случай основното ограничение е било натоварването върху базата данни, затова тя получава собствен специализиран хардуер.
Електронната поща е критична за бизнеса и разполага със собствена резервираност.
DNS услугата работи от отделна локация, което гарантира, че домейнът ще остане достъпен дори при сериозен проблем с основния център за данни.
Тези два примера показват най-важното предимство на клъстерната архитектура: няма универсална конфигурация.
Всеки бизнес крие различни рискове, затова инфраструктурата трябва да бъде проектирана според конкретните нужди.
Именно това е силата на архитектурата, базирана на роли – инвестирате в резервираност там, където тя носи реална стойност, вместо да увеличавате ненужно разходите за цялата инфраструктура.
Ограниченията: Какво клъстерът НЕ може да направи
Важно е да познавате не само предимствата, но и ограниченията на клъстерната архитектура. Именно те често определят дали това е правилното решение за вашия проект.
- Клъстерът не е резервно копие
Това е едно от най-често срещаните погрешни схващания.
Репликацията копира абсолютно всички промени между nodesте – както правилните, така и грешните. Ако по невнимание изтриете таблица от базата данни или внедрите проблемна версия на приложението, тази промяна ще бъде репликирана към всички nodes почти незабавно.
Ако основният ви риск е човешка грешка, а не хардуерен отказ, надеждните резервни копия с възможност за възстановяване до конкретен момент (Point-in-Time Recovery) са далеч по-важни от самия клъстер.
- Клъстерът не осигурява автоматично мащабиране
Добавянето и премахването на nodes не става автоматично при внезапен пик в натоварването. Инфраструктурата се разширява от техническия екип на NS1 при необходимост.
Процесът е бърз, но не представлява автоматичен autoscaling, при който нови сървъри се стартират секунди след увеличаване на трафика.
- Клъстерът не заменя CDN
Клъстерът решава проблема с наличността и капацитета. CDN решава съвсем различен проблем – бързото доставяне на статично съдържание като:
- изображения;
- CSS файлове;
- JavaScript;
- видео и други ресурси.
Двете технологии се допълват.
Най-добри резултати се постигат, когато CDN работи пред клъстерната инфраструктура.
- Общото хранилище не е разпределена файлова система
В рамките на клъстера съществува един Storage Node, който предоставя общото NFS хранилище. Той работи върху надежден хардуер и използва механизми за отказоустойчивост на ниво виртуализационна платформа.
Въпреки това добавянето на нови nodes не увеличава резервираността на самото файлово хранилище в рамките на един клъстер.
- Клъстеризацията е налична само за MariaDB
В описаната архитектура клъстеризацията на базите данни се реализира чрез MariaDB Galera Cluster.
Други системи като PostgreSQL не участват автоматично в тази архитектура и изискват различен подход за изграждане на отказоустойчива среда.
- Репликацията между различни центрове за данни е асинхронна
В рамките на един дейта център Galera използва синхронна репликация.
Когато инфраструктурата е разпределена между различни центрове за данни, латентността прави синхронната работа непрактична. Затова между отделните региони се използва асинхронна репликация. При сериозен регионален отказ е възможно да бъдат загубени последните няколко секунди записани данни.
Как да изберете между един VPS и Cluster Hosting
Решението може да бъде сведено до четири последователни стъпки.
1. Изчислете цената на downtime-a
Определете колко струва един час недостъпност през най-натоварения период на бизнеса ви. След това сравнете тази стойност с месечната цена на допълнителните сървъри.
2. Проверете дали сте достигнали лимита на настоящия сървър
Ако процесорът, паметта или дисковата система редовно работят близо до максималния си капацитет през нормална работна седмица, инфраструктурата вече се е превърнала в ограничение.
3. Уверете се, че няма по-евтино решение
Бавният сайт невинаги означава нужда от клъстер.
Причината може да бъде:
- липса на кеширане;
- неоптимизирани SQL заявки;
- тежки плъгини;
- неефективен код.
Оптимизацията на приложението често премахва необходимостта от хоризонтално мащабиране.
4. Изберете правилната архитектура
Преди да планирате изграждането на клъстер, определете къде се намира реалният риск.
Запитайте се:
- проблемът е наличността?
- базата данни?
- електронната поща?
- DNS инфраструктурата?
Отговорът определя необходимата топология и значително улеснява проектирането на решението.
Заключение
Решението между един VPS сървър и клъстер не зависи от размера на сайта.
То зависи от две неща:
- колко струва един час downtime за бизнеса ви;
- доколко настоящият сървър е близо до своите реални лимити.
За повечето сайтове един добре конфигуриран VPS остава най-разумният избор.
Но когато надеждността и непрекъсваемата работа се превърнат в критичен фактор, правилно проектираният клъстер е естествената следваща стъпка.
Важно е да запомните, че успехът не зависи от броя на сървърите, а от архитектурата.
Добре проектираният клъстер, съобразен с реалните нужди на бизнеса, почти винаги е по-ефективен от просто добавянето на още машини.
Често задавани въпроси (FAQ)
В: Кога бизнесът трябва да премине от един VPS сървър към клъстер?
О: Когато потенциалните загуби от downtime станат по-големи от инвестицията в допълнителната инфраструктура или когато един сървър вече не може да поеме натоварването в пиковите моменти.
Ако кратко прекъсване би довело до сериозни финансови загуби или системата редовно достига лимитите си по отношение на процесор, памет или дискова система, клъстерът вече е оправдано решение.
В: Прави ли клъстерът сайта по-бърз?
О: Не директно. Клъстерът увеличава капацитета и надеждността, но всяка отделна заявка продължава да се изпълнява върху един конкретен сървър.
Ако сайтът е бавен заради неоптимизиран код или липса на кеширане, клъстерът няма да реши този проблем.
В: Какъв е минималният практичен размер на клъстер?
О: Три node-а. Теоретично могат да се използват два, но Galera изисква мнозинство от node-овете с бази данни, за да приема нови записи.
При два node-а отпадането на единия блокира всички операции по запис. При три node-а системата продължава да функционира нормално дори след отказ на един сървър.
В: Как се поддържа еднакво съдържание между всички сървъри?
О: Файловете се намират само на едно място – Storage Node, който ги предоставя чрез NFS към останалите nodes.
Базите данни работят по различен начин. Всеки node има собствено локално копие на MariaDB, а Galera синхронизира всички промени между тях преди операцията да бъде потвърдена. Акаунтите, домейните и системните потребители също се синхронизират автоматично.
В: Мога ли сам да добавям нови nodes през SPanel?
О: Не. Cluster Management е предназначен за наблюдение на инфраструктурата.
Добавянето или премахването на nodes, промяната на ролите и цялостната архитектура се извършват от техническия екип на NS1. Това е съзнателно решение, тъй като подобни операции са критични и не бива да се извършват чрез интерфейс за самообслужване.
В: Замества ли клъстерът резервните копия?
О: Не. Репликацията копира всяка промяна – включително нежеланите. Случайно изтриване на данни или проблемна актуализация ще се разпространят към всички nodes по същия начин, както и нормалните промени.
Затова независимите резервни копия остават задължителни.
В: Колко бързо става превключването при failover?
О: При базите данни MaxScale обикновено пренасочва заявките само за няколко секунди – често толкова бързо, че посетителите дори не забелязват промяната.
При уеб трафика времето зависи от използвания load balancer, който следи здравословното състояние на node-овете и автоматично спира да изпраща заявки към проблемния сървър.
В: Какви типове клъстерни архитектури предлага NS1?
О: Основните варианти са четири:
- Full Cluster – всеки node изпълнява всички услуги;
- Dedicated Database Nodes – отделни сървъри за MariaDB с MaxScale за маршрутизиране на заявките;
- Mail Redundancy – специализирани Exim и Dovecot сървъри за резервиране на електронната поща;
- DNS-Only Nodes – самостоятелни BIND сървъри, обикновено разположени в отделен център за данни за максимална надеждност на DNS услугата.